# Шесть паттернов оркестрации AI-агентов: с чего начинать и когда усложнять
> Один агент в цикле, цепочка, маршрутизация, параллельные ветки, оркестратор с исполнителями и цикл «генератор — критик». Когда какой паттерн нужен, сколько он стоит в токенах и как не усложнить систему раньше времени.
Источник: https://blog.uspeshnyy.ru/blog/patterny-orkestracii-ai-agentov/
Автор: Александр Успешный · blog.uspeshnyy.ru
Опубликовано: 2026-04-28
Теги: AI-агенты, автоматизация, система
---
Когда автоматизация перерастает один промпт, появляется соблазн сразу строить команду: агент-исследователь, агент-писатель, агент-редактор, над ними — агент-руководитель. На схеме это выглядит солидно. В счёте — тоже.
По данным Anthropic из [разбора их исследовательской системы](https://www.anthropic.com/engineering/multi-agent-research-system), агент в среднем тратит примерно в 4 раза больше токенов, чем обычный чат, а система из нескольких агентов — примерно в 15 раз больше. Такая архитектура оправдана только там, где ценность задачи окупает этот множитель.
Поэтому паттерны оркестрации полезно видеть не как меню, а как лестницу. Начинать с нижней ступени и подниматься выше, только когда упёрлись в конкретное ограничение. Этот принцип Anthropic формулирует прямо в [руководстве по построению агентов](https://www.anthropic.com/engineering/building-effective-agents): ищите самое простое решение и усложняйте, только когда это действительно нужно. Сводную таблицу паттернов с оценкой стоимости ведёт и [Vercel](https://vercel.com/i/agent-orchestration-patterns).
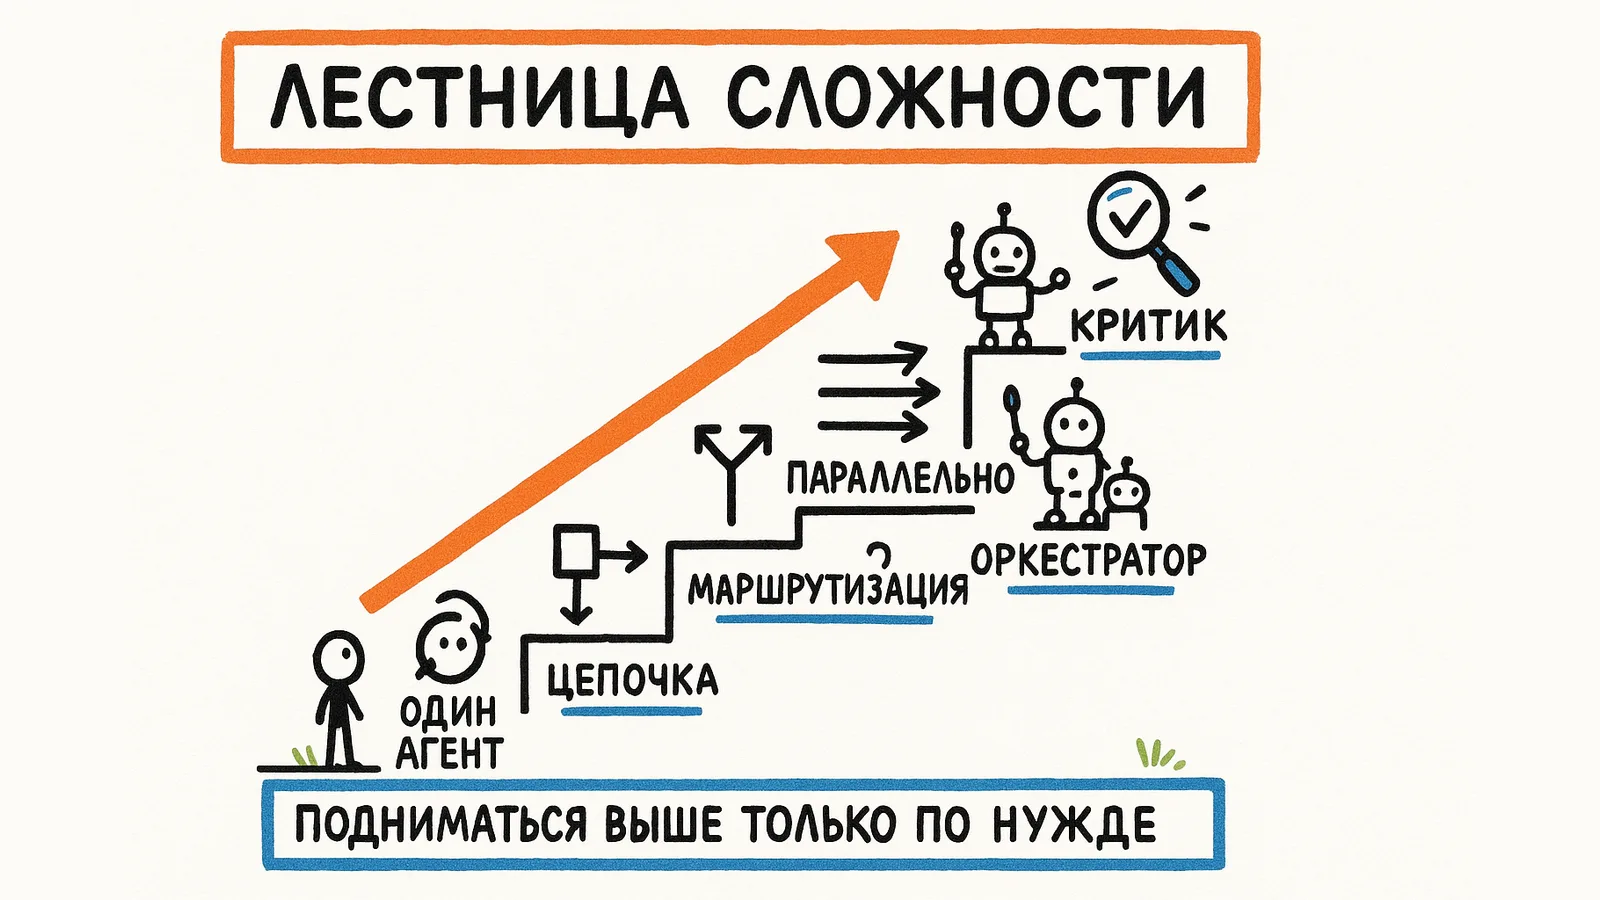
## Шесть ступеней одной таблицей
| Паттерн | Когда подходит | Расход токенов | Когда не нужен |
|---|---|---|---|
| Один агент в цикле | Задача помещается в одно окно контекста, агенту хватает инструментов | Базовый | Есть действительно независимые подзадачи |
| Цепочка шагов | Шаги известны заранее и не меняются | Умеренный, растёт с длиной цепочки | Границы шагов непонятны до запуска |
| Маршрутизация | Входы разных типов лучше обрабатывать по-разному | Низкий | Все входы обрабатываются одинаково |
| Параллельные ветки | Независимые подзадачи известны заранее | Высокий, растёт с числом веток | Шаги зависят друг от друга |
| Оркестратор и исполнители | Какие подзадачи нужны, становится ясно только в работе | Высокий, растёт с числом исполнителей | Подзадачи предсказуемы |
| Генератор и критик | Есть чёткие критерии, и ответ улучшается от правок | Умеренный, растёт с числом кругов | Нужен мгновенный ответ или нет критериев |
Дальше — каждая ступень подробнее, с признаками, по которым пора подниматься.
## 1. Один агент в цикле
Модель вызывает инструмент, смотрит на результат, добавляет его в контекст и решает, что делать дальше. Так — пока не выполнено условие остановки.
Это стартовая точка почти для любой задачи, и она сильнее, чем кажется. В [исследовании апреля 2026 года](https://arxiv.org/abs/2604.02460) одиночного агента сравнили с несколькими архитектурами из многих агентов на задачах многошагового рассуждения. Главное условие — **одинаковый бюджет токенов на рассуждение**. Проверяли на трёх семействах моделей: Qwen3, DeepSeek-R1-Distill-Llama и Gemini 2.5. Один агент стабильно не уступал команде, а часто оказывался лучше.
Авторы делают осторожный вывод: заявленное преимущество систем из многих агентов на таких задачах во многом объясняется тем, что им просто давали больше вычислений. Они же отмечают, когда команда становится конкурентоспособной: если одиночный агент плохо использует свой контекст или если на задачу тратят больше вычислений.
**Когда подниматься выше:**
- контекст не помещается в одно окно;
- в задаче есть по-настоящему независимые части, которые выгодно делать одновременно;
- агент начинает путаться в состоянии — повторяет уже сделанные поиски, забывает промежуточные результаты.
И одно правило для этой ступени без исключений: **у цикла должен быть предел шагов**. Иначе агент, который не нашёл ответ, будет искать его за ваш счёт.
## 2. Цепочка шагов
Фиксированная последовательность вызовов: каждый обрабатывает результат предыдущего. Цепочка сужает задачу на каждом шаге и поэтому обычно точнее одного большого промпта.
Но у неё есть математическая ловушка. Ошибки шагов накапливаются. Если каждый шаг верен в 95% случаев, цепочка из десяти шагов сработает целиком примерно в 60% случаев. При 90% на шаг — примерно в 35%.
Отсюда главное правило цепочки: **между шагами ставятся программные проверки**. Правильный ли формат, все ли обязательные поля на месте, не нарушены ли ограничения, нужно ли подтверждение человека. Плохой промежуточный результат должен останавливаться на проверке, а не уезжать дальше.
Пример из нашего бота: аудит репутации по картам. По адресу сайта бот определяет бренд и город, ищет компанию на Яндекс.Картах, собирает отзывы с трёх площадок, отдаёт их модели на разбор и собирает отчёт. Ключевая проверка стоит в самом начале. Название на сайте часто не совпадает с названием на картах, поэтому бот берёт каноническое имя из найденной карточки Яндекса и уже по нему ищет компанию в 2ГИС. Без этого шага цепочка честно собрала бы отзывы о чужой компании.
## 3. Маршрутизация
Первый шаг классифицирует вход и отправляет его нужному обработчику. Вопрос про оплату — в одну ветку, жалоба — в другую, запрос на отчёт — в третью. Каждый обработчик может иметь свой промпт и даже свою модель.
У маршрутизации есть потолок: **система не может быть точнее своего маршрутизатора**. Ошибся классификатор — и специалист получил не свою работу.
Поэтому, где только возможно, маршрут стоит определять **правилами, а не моделью**: по ключевым словам, по источнику, по кнопке, которую нажал человек. Это убирает целый источник ошибок. В нашем боте так устроены точки входа: ссылка из поста уже содержит код нужного отчёта, и бот сразу запускает нужный сценарий без всякой классификации. А в кейсе [UspAIChat](/blog/keys-uspaichat-selfhosted-ai-chat/) эвристический маршрутизатор без модели отправляет простые запросы в дешёвые модели. Та же логика на уровне бюджета разобрана в статье [за какую AI-модель платить](/blog/za-kakuyu-ai-model-platit/).
Если без модели в классификации не обойтись, проверьте её на реальных входах, а не на аккуратном списке категорий. Чистая таксономия на бумаге ничего не говорит о спорных случаях.
## 4. Параллельные ветки
Независимые подзадачи выполняются одновременно, а результаты собираются программно. У паттерна две разновидности, которые Anthropic разделяет в своём руководстве:
- **Разделение на части.** Задачу режут на независимые куски: например, одна ветка проверяет отзывы, другая — сайт, третья — цены конкурентов.
- **Голосование.** Одну и ту же задачу решают несколько раз или несколькими моделями, чтобы повысить уверенность в ответе.
Правило, которое чаще всего нарушают: **способ сборки результатов определяется до запуска веток**. Если ветки вернут несовместимые форматы, весь выигрыш по времени съест склейка.
Пример из бота — A/B-тест моделей. Один промпт уходит во все модели набора одновременно, ответы приходят без названий, и оценивает их человек. Это голосование, только голос у человека. Подробнее о том, как проектировать ветвление, не теряя время на ожидании самой медленной ветки, — в статье [граф вместо цепочки](/blog/graf-vmesto-cepochki-arhitektura-ai-agentov/).
## 5. Оркестратор и исполнители
Центральная модель сама решает, на какие подзадачи разбить работу, раздаёт их исполнителям и собирает результат. Отличие от параллельных веток в одном: там подзадачи известны заранее, здесь — только в процессе.
Классический случай — правка кода, где количество затронутых файлов зависит от запроса. Или исследование, где непонятно заранее, сколько направлений придётся проверить.
Именно здесь многоагентные системы показывают себя лучше всего. В той же публикации Anthropic система с Claude Opus 4 в роли руководителя и Claude Sonnet 4 в роли исполнителей обошла одиночный Claude Opus 4 на 90,2% во внутреннем тесте исследовательских задач — на запросах «вширь», где нужно параллельно проверить много направлений. Но там же сказано, от чего это зависит: на тесте BrowseComp расход токенов сам по себе объяснил 80% разницы в результатах.
Этот результат не спорит с исследованием одиночного агента из первого раздела, а дополняет его. Команда агентов выигрывает, когда ей дают больше вычислений на задачу, которая действительно раскладывается на независимые направления. Если задача узкая, а бюджет тот же, лишние агенты ничего не добавят, кроме координации.
Как это устроено в Claude Code, разбирал в статье про [Agent Teams](/blog/agent-teams-claude-code/), а на маркетинговых задачах — в разборе [отдела маркетинга на Claude Code](/blog/otdel-marketinga-na-claude-code/).
## 6. Генератор и критик
Одна модель создаёт ответ, другая оценивает его по критериям и возвращает замечания. Круг повторяется, пока ответ не пройдёт порог качества или не кончится лимит кругов.
Паттерн окупается при двух условиях: есть **чёткая рубрика**, и ответ **действительно улучшается** от замечаний. Хорошая проверка перед запуском: если человек может сформулировать полезную правку к черновику, скорее всего, сможет и модель.
Главная опасность — **бесконечный круг критики**. При расплывчатых критериях вроде «сделай лучше» критик всегда найдёт, что поправить, и цикл будет крутиться, пока не кончатся деньги. Лимит кругов задаётся в коде, а не в промпте.
Упрощённая версия есть и в нашем боте: проверка текста на штампы. Каталог шаблонных фраз и разбор моделью находят проблемные места и сразу предлагают вариант «было → стало» — за один проход, без повторного круга. Как составить рубрику, по которой критик будет оценивать тексты, разобрано в статье про [голос бренда в AI-контенте](/blog/golos-brenda-v-ai-kontente/).
## Как выбрать ступень
Паттерны не взаимоисключающие. Маршрутизатор может отправлять запрос в цепочку, один из шагов цепочки — запускать параллельные ветки, а на выходе может стоять критик. Лестница задаёт не выбор одного варианта, а порядок: сначала простая форма, сложная — только там, где простая упёрлась в ограничение.
## Две ошибки, которые встречаются чаще всего
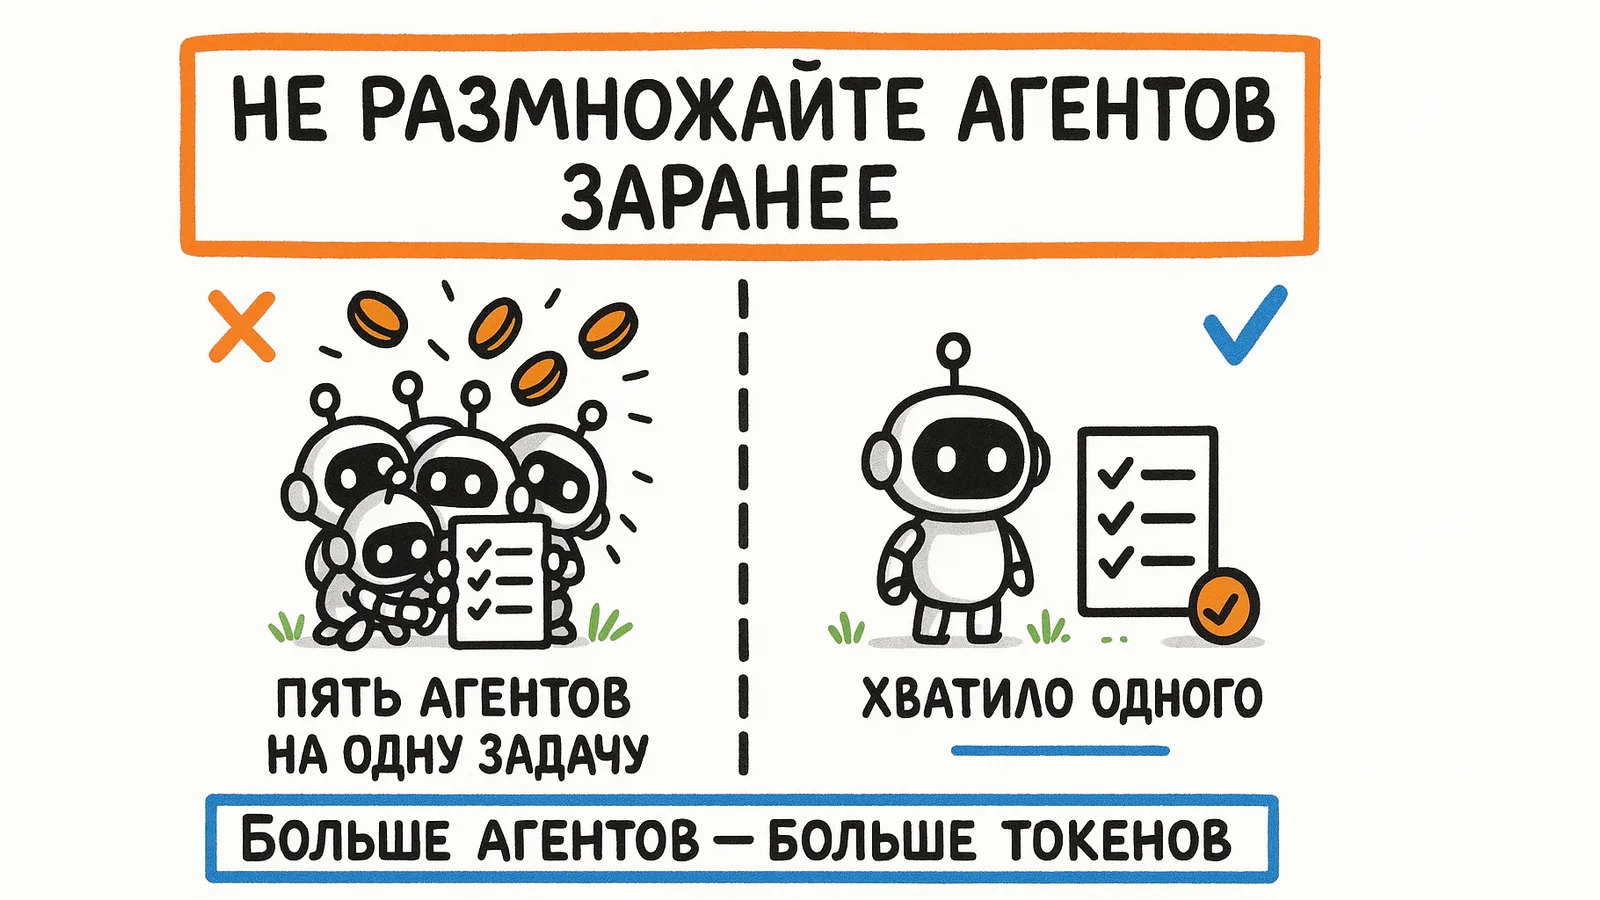
**Преждевременное размножение агентов.** Команда агентов появляется раньше, чем у задачи обнаружились независимые части. Стоимость растёт кратно, а вместе с ней — число мест, где что-то может сломаться. Лечится вопросом: какое конкретное ограничение одиночного агента мы этим снимаем? Если ответа нет — агент один.
**Сложная схема без наблюдения.** Чем больше шагов и агентов, тем тише ломается система: каждый отдельный вызов выглядит нормально, а результат неверный. Прежде чем подниматься на следующую ступень, стоит научиться видеть, что происходит внутри одной задачи. Что записывать и за какими числами следить, разобрано в статье [как следить за AI-ботом в работе](/blog/kak-sledit-za-ai-botom-v-rabote/).
## Вывод
Шесть паттернов оркестрации — это лестница, а не меню. Один агент в цикле закрывает больше задач, чем кажется, а при равном бюджете часто не уступает команде. Цепочке нужны проверки между шагами, маршрутизации — правила вместо модели, где это возможно, параллельным веткам — заранее продуманная сборка, оркестратору — задача, которая действительно раскладывается на независимые направления, критику — рубрика и лимит кругов.
**Следующий шаг:** возьмите свою текущую автоматизацию и назовите её паттерн. Затем ответьте на один вопрос: какое конкретное ограничение заставило выбрать именно эту ступень? Если ответа нет, попробуйте опуститься на ступень ниже и сравнить результат и расход.
## Читайте также
Хотите разобрать свою автоматизацию и подобрать ей правильную ступень — [напишите мне в Telegram](https://t.me/uspeshnyy).