Как подготовить сайт к AI-агентам: чек-лист из 7 шагов
Как проверить AI-готовность сайта и что исправить: правила robots.txt для GPTBot, ClaudeBot, PerplexityBot и YandexAdditional, Content Signals, markdown-версии страниц и llms.txt. Семь шагов с примерами и командами проверки.
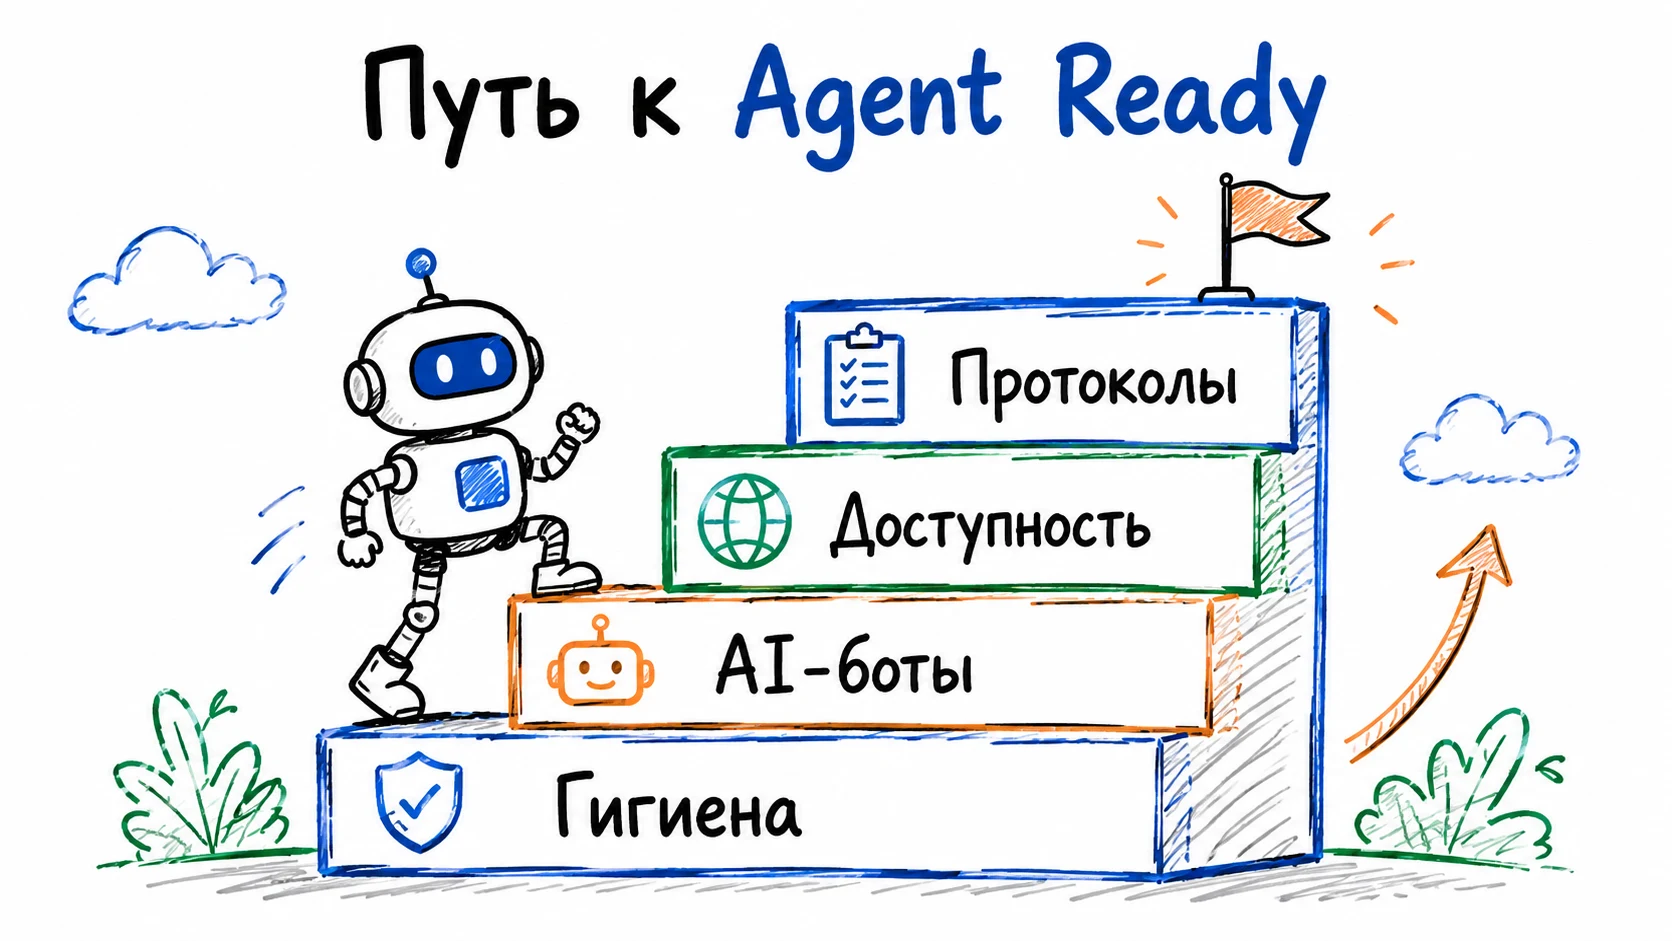
Раньше я разбирал, что такое Agent Ready Web и почему готовность сайта к AI-агентам — это следующий SEO. Тот материал отвечает на вопрос «зачем». Этот — на «как»: семь шагов от простого к продвинутому, и к каждому — пример и команда, которой можно проверить себя за минуту.
Примеры взяты с этого блога: в сентябре я прошёл по списку сам, так что всё ниже работает на живом сайте.
Не нужно делать всё сразу. Первые шаги дают максимум за минимум усилий, дальше — по мере готовности.
Сначала — кто на самом деле приходит
Прежде чем готовиться к агентам, полезно увидеть, что они уже здесь. Я посчитал в журнале сервера запросы к статьям этого блога за две недели сентября, со 2 по 16 число. Боты определены по заголовку User-Agent, без проверки адресов, так что цифры — ориентир, а не аудит.
| Кто | Запросов к статьям | Разных статей |
|---|---|---|
| Bing — поиск | 608 | 118 |
| Яндекс — поиск | 309 | 120 |
| Google — поиск | 214 | 84 |
| Perplexity — поисковый индекс | 211 | 140 |
| Anthropic — сбор данных для обучения | 197 | 196 |
| OpenAI — поиск ChatGPT | 47 | 47 |
| OpenAI — сбор данных для обучения | 46 | 27 |
| ChatGPT по запросу пользователя | 32 | 31 |
| Claude по запросу пользователя | 19 | 5 |
Две последние строки — самое интересное. Это не краулеры, а случаи, когда человек задал вопрос ChatGPT или Claude, и ассистент пошёл читать нашу статью, чтобы ответить. А робот Anthropic за две недели прочитал 196 статей из 197, то есть практически весь блог.
Если сайт для таких ботов закрыт, он выпадает из этого потока целиком. Если открыт, но отдаёт пустую вёрстку, ассистент ответит без вас.
Шаг 1: валидный robots.txt
Первое, что читает любой робот. Файл должен лежать в корне, отвечать кодом 200 и весить меньше 500 КБ — больший Яндекс не обработает.
curl -sI https://ваш-сайт.ru/robots.txt | head -1 # HTTP/2 200Ловушка, на которой я споткнулся сам. Если сайт за Cloudflare, у зоны по умолчанию может быть включён управляемый robots.txt: сервис сам дописывает Disallow: / для GPTBot, ClaudeBot и других AI-ботов. Ваш файл на сервере при этом выглядит нормально, а нейросети сайт не видят. Проверяйте ответ снаружи, а не файл на диске.
Шаг 2: sitemap с датами изменений
Карта сайта говорит, какие страницы есть. Даты lastmod говорят, какие из них изменились и стоит перечитать. Без дат робот обходит всё подряд или не обходит ничего.
Ссылку на карту — в robots.txt, директивой Sitemap:.
curl -s https://ваш-сайт.ru/robots.txt | grep -i sitemap
curl -s https://ваш-сайт.ru/sitemap-index.xml | head -20
Вместе первые два шага — базовая гигиена. Большинство сайтов на этом уровне и останавливаются.
Шаг 3: правила для AI-ботов
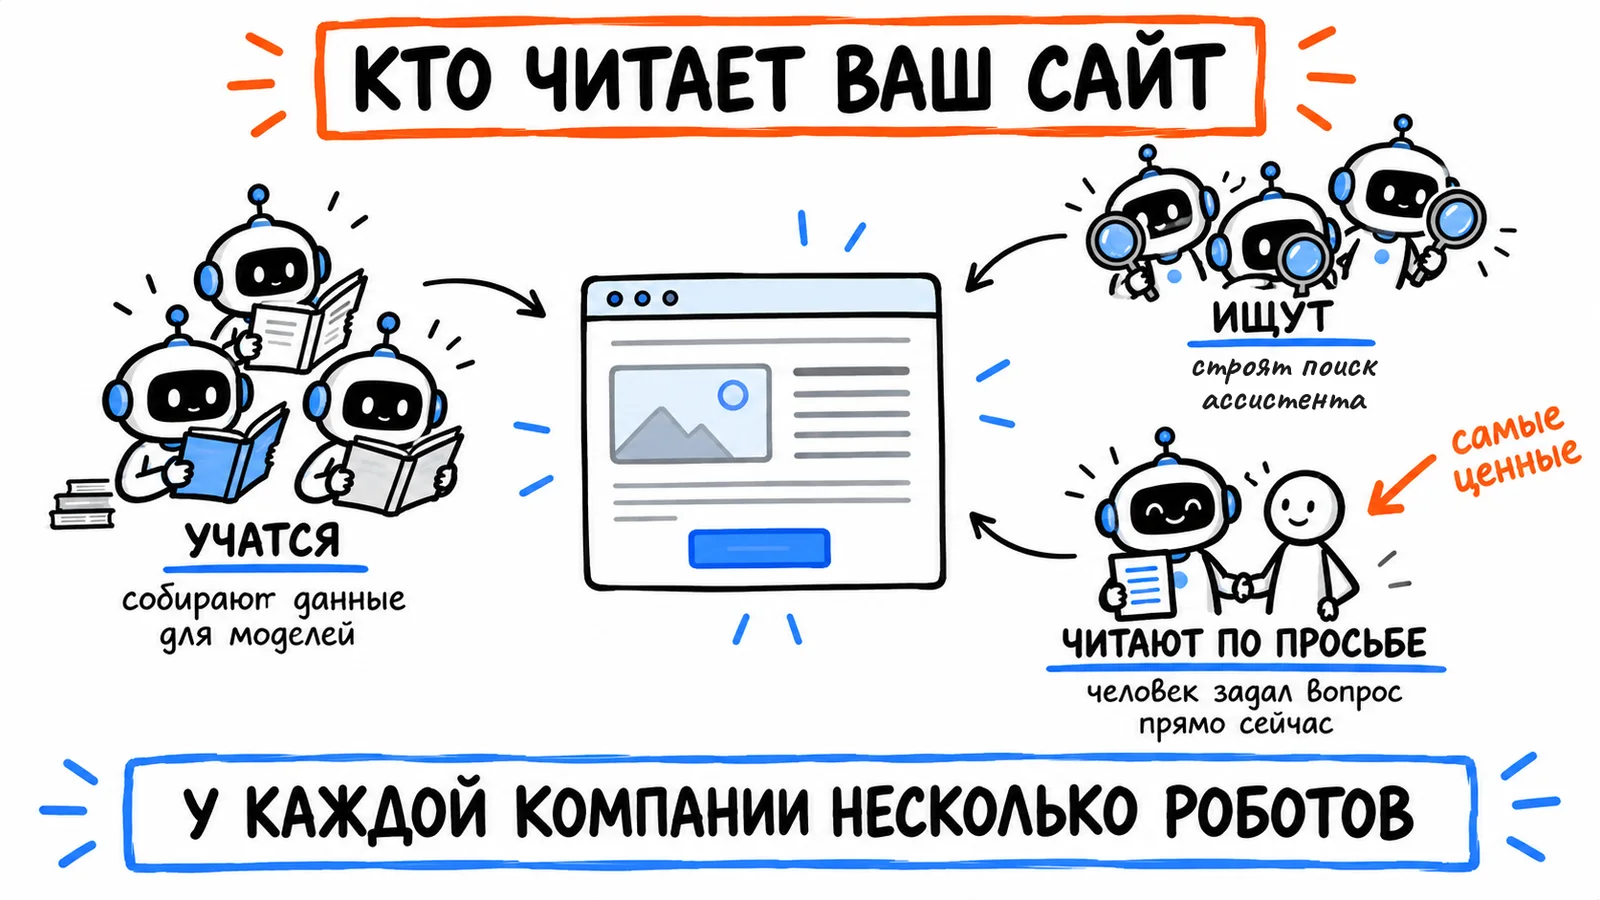
У крупных компаний не один робот, а несколько, и у каждого своя задача. Правила лучше писать для каждого отдельно: по стандарту robots.txt робот следует той группе, где упомянут он сам, а общую * читает, только если своей не нашёл.
| Компания | Робот | Зачем приходит |
|---|---|---|
| OpenAI | GPTBot |
собирает данные для обучения моделей |
| OpenAI | OAI-SearchBot |
индексирует сайты для поиска в ChatGPT |
| OpenAI | ChatGPT-User |
открывает страницу, когда об этом попросил пользователь |
| Anthropic | ClaudeBot |
собирает данные для обучения |
| Anthropic | Claude-SearchBot |
улучшает поиск Claude |
| Anthropic | Claude-User |
открывает страницу по запросу пользователя |
| Perplexity | PerplexityBot |
индексирует сайты для выдачи Perplexity, не для обучения |
| Perplexity | Perplexity-User |
открывает страницу по запросу пользователя |
Google-Extended |
не робот, а метка: разрешает или запрещает использовать сайт для Gemini. На поиск Google не влияет | |
| Яндекс | YandexAdditional |
управляет показом контента сайта в ответах Алисы AI; подробнее об ответах Алисы |
Важная деталь: роботы, которые приходят по запросу пользователя, robots.txt могут и не соблюдать. У OpenAI так и написано: для ChatGPT-User правила могут не применяться. У Perplexity — что Perplexity-User, как правило, их игнорирует. Логика понятна: страницу открывает не краулер, а человек через ассистента.
Кусок нашего файла:
User-agent: GPTBot
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /

User-agent: OAI-SearchBot
Content-Signal: search=yes, ai-input=yes
Allow: /

User-agent: ClaudeBot
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /

User-agent: YandexAdditional
Allow: /
Шаг 4: Content Signals
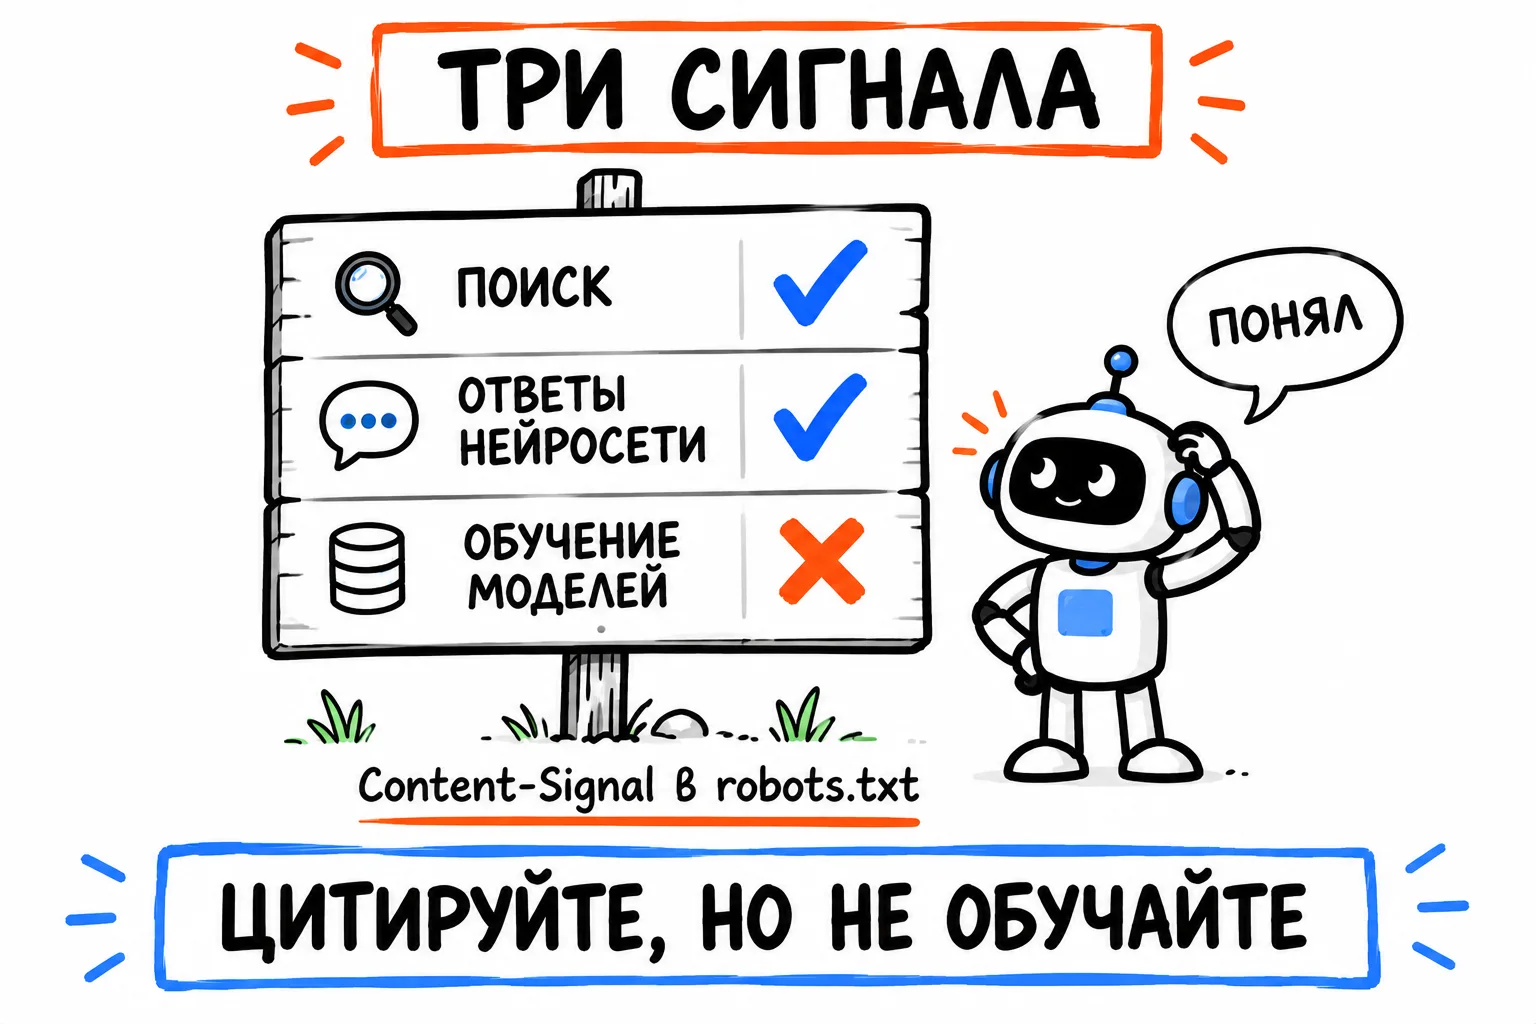
Allow и Disallow решают, пускать ли робота. Content Signals — инициатива Cloudflare — добавляют второй вопрос: что можно делать с тем, что он прочитал.
Три значения, каждое — yes или no:
search— строить поисковый индекс и показывать ссылки с короткими фрагментами;ai-input— подставлять текст в ответ нейросети прямо сейчас;ai-train— обучать или дообучать модели.
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /
Так записано у нас: индексируйте и цитируйте, но не обучайте. Это заявление о предпочтениях, а не замок: честные компании его учитывают, остальные — нет. Но без него ваша позиция не записана вовсе.
Шаг 5: текстовые версии страниц
Агенту тяжело продираться через HTML с меню, скриптами и счётчиками. Статья этого блога про удаление отзывов весит 150 КБ, а её текстовая версия — 19 КБ: всё остальное агенту не нужно. Решение, которое предлагает стандарт llmstxt.org: рядом со страницей лежит её markdown-версия.
У нас к адресу любой статьи можно добавить .md — и получить чистый текст с заголовком, описанием и датой. В шапке HTML на неё указывает ссылка:
<link rel="alternate" type="text/markdown" href="https://blog.uspeshnyy.ru/blog/kak-udalit-otzyv.md">Ловушка №2. Сервер по умолчанию не знает расширение .md и отдаёт такой файл как application/octet-stream — браузер и агент его скачивают, а не читают. Нужна одна строка в конфигурации: для .md — тип text/markdown.
curl -sI https://ваш-сайт.ru/blog/статья.md | grep -i content-type
# content-type: text/markdown; charset=utf-8
Шаг 6: указатель для моделей — llms.txt
Файл в корне сайта, который коротко объясняет модели, что здесь есть: заголовок, описание, разделы со ссылками. Формат — тот же llmstxt.org. Наш: blog.uspeshnyy.ru/llms.txt — описание блога и свежие статьи по рубрикам, каждая ссылка ведёт сразу на markdown-версию.
# Александр Успешный — AI-маркетинг как система

> Блог о практическом применении AI в маркетинге и продажах…

## Кейсы

- [Сайт и AI-агент для продажи одного дома](https://blog.uspeshnyy.ru/blog/keys-barhat-sayt-i-agent.md): …
Не все модели этот файл читают, и гарантий он не даёт. Но он дешёвый: у нас он генерируется при каждой сборке блога из тех же статей и не может разойтись с сайтом.
Шаг 7: агентные протоколы (MCP и дальше)
Вершина — когда сайт не просто читается, а даёт агенту инструменты: подключение к данным и сервисам через MCP, каталог возможностей, авторизацию, оплату. Это уже не «сайт, который можно прочитать», а «сайт, с которым агент может работать».
Для блога это лишнее. Для сервиса с API, записью или корзиной именно здесь начинается настоящее преимущество, но только после того, как закрыты шаги 1–6.
Проверьте себя за пять минут
S=https://ваш-сайт.ru

curl -sI $S/robots.txt | head -1                          # файл отвечает
curl -s  $S/robots.txt | grep -iE "gptbot|claudebot|perplexity|yandexadditional|content-signal"
curl -s  -A "GPTBot" -o /dev/null -w "%{http_code}\n" $S/  # защита не режет AI-ботов
curl -s  $S/ | sed 's/<[^>]*>//g' | wc -w                 # сколько слов видно без JavaScript
curl -sI $S/llms.txt | head -1
Предпоследняя строка важнее, чем кажется. Если сайт рисует содержимое скриптом, робот увидит несколько десятков слов вместо тысячи — и вся подготовка выше не сработает.
А если есть доступ к серверу, посмотрите, кто к вам уже ходит:
grep -ciE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|PerplexityBot" /var/log/nginx/access.logКак двигаться по списку
flowchart LR
    A["1–2. Гигиена<br/>robots + sitemap"] --> B["3–4. AI-боты<br/>правила + сигналы"]
    B --> C["5–6. Доступность<br/>markdown + llms.txt"]
C --> D["7. Протоколы<br/>MCP и агенты"]- Шаги 1–2 делаются за час и дают базу.
- Шаги 3–4 — ещё час: вы осознанно решаете, кого пускать и на каких условиях.
- Шаги 5–6 требуют разработчика, но один раз: дальше всё генерируется само.
- Шаг 7 — отдельный проект, когда у сайта есть что предложить агенту кроме текста.
Техническая готовность — половина дела. Вторая половина — чтобы нейросеть, прочитав вас, захотела сослаться на вас в ответе. Это уже про содержание, а не про файлы.
Что с этим делать
Прогоните пять команд выше на своём сайте. Если первые две строки пустые или с ошибкой — начните с шагов 1–3: это вечер работы, после которого сайт перестаёт быть невидимым для нейросетей.
Проверить свой сайт по тем же признакам можно и без командной строки: пришлите адрес — бот покажет, что видит AI-краулер и чего ему не хватает.
🤖 Проверить видимость в ИИ-поискеБесплатно, в Telegram-боте @uspeshnyybot
Комментарии
Войдите через Telegram, чтобы оставить комментарий:
Пока нет комментариев. Будьте первым.