# RLHF: как нейросеть учится отвечать так, как нравится людям — разбор лекции Стэнфорда
> Что такое RLHF — обучение с подкреплением на человеческой обратной связи. Как базовая модель становится ассистентом: SFT, reward model, PPO, DPO, и почему «нравится людям» не значит «верно».
Источник: https://blog.uspeshnyy.ru/blog/rlhf-kak-model-uchitsya-otvechat-kak-hotyat-lyudi/
Автор: Александр Успешный · blog.uspeshnyy.ru
Опубликовано: 2026-10-05
Теги: нейросети, промпты
---
После предобучения языковая модель уже умеет продолжать текст и знает очень много. Но это ещё не ассистент: она не обязана следовать инструкциям, быть вежливой или признавать, что чего-то не знает. Превращает «знающую модель» в «полезного собеседника» отдельный этап — **RLHF, Reinforcement Learning from Human Feedback**, обучение с подкреплением на человеческой обратной связи.
Как он устроен, подробно разбирается в лекции курса Stanford CS229 «Building Large Language Models (LLMs)». Ниже — её логика простыми словами и то, что из неё следует для тех, кто работает с нейросетями каждый день.
## Три ступени: знания, инструкции, предпочтения
Путь модели к ассистенту обычно проходит три этапа:
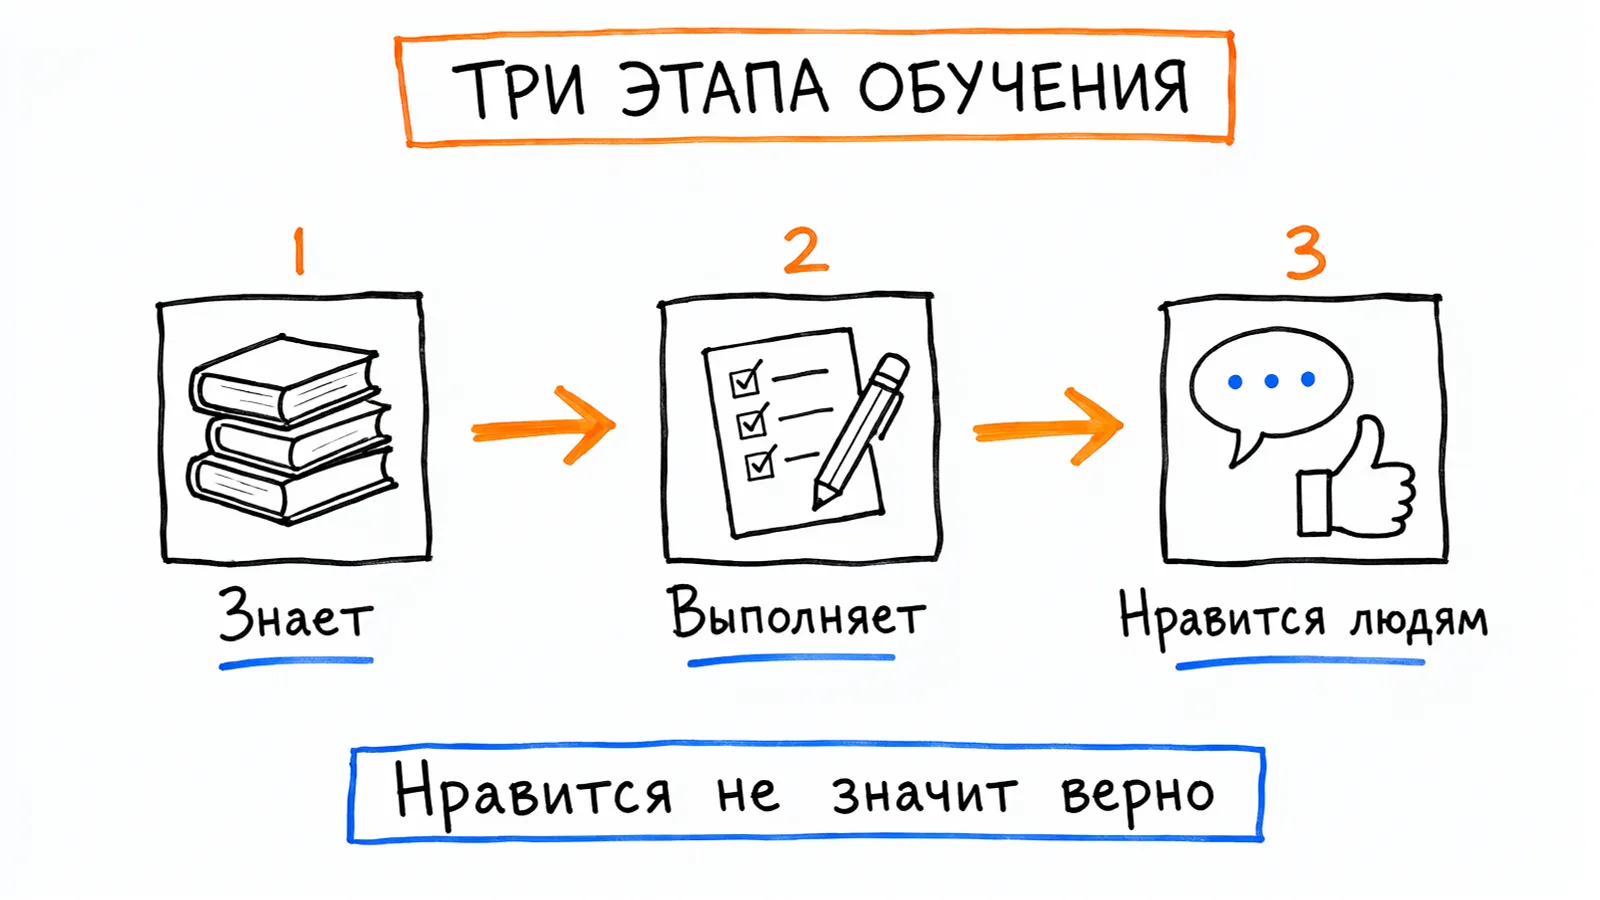
- **Pretraining** — модель читает огромные массивы текста. Результат: умеет говорить и много знает.
- **SFT, supervised fine-tuning** — модели показывают примеры хороших ответов на запросы. Результат: учится выполнять инструкции.
- **RLHF** — модель учится отвечать так, как предпочитают люди.
У SFT есть слабое место: людям дорого и сложно каждый раз писать идеальный эталонный ответ. Для RLHF придумали более удобный вид обратной связи — **сравнение**. Человеку гораздо проще посмотреть на два-три варианта и сказать «этот лучше», чем сочинить безупречный ответ с нуля.
## Как работает RLHF
По шагам:
1. Запрос подаётся в модель.
2. Модель генерирует несколько вариантов ответа.
3. Люди ранжируют ответы по качеству.
4. На этих предпочтениях обучается **reward model** — отдельная модель, которая пытается предсказать, какой ответ человек выбрал бы.
5. Основную модель дообучают так, чтобы она чаще получала высокую оценку reward model. В классическом RLHF для этого часто используют алгоритмы reinforcement learning вроде **PPO**.
Например, на запрос «объясни юридический термин простыми словами» модель создаёт три ответа. Оценщик выбирает тот, что точнее, понятнее и без лишних утверждений. После множества таких сравнений система постепенно учится предпочитать ответы такого типа.
## Что RLHF меняет, а что нет
Главная роль RLHF — не добавить модели новые факты, а **изменить её поведение**. Он помогает сделать её:
- полезнее и понятнее;
- вежливее и последовательнее;
- безопаснее;
- ближе к человеческим предпочтениям.
Это важное различие: **pretraining формирует знания и базовые способности, а RLHF — то, как модель ими пользуется**. Поэтому одна и та же база может превратиться в очень разных ассистентов в зависимости от того, чьи предпочтения заложили в обучение. Общую картину всего конвейера — от данных до финальной полировки — мы разбирали в статье [«Как делают GPT и Claude: конвейер из 5 этапов»](/blog/kak-obuchayut-llm-5-etapov/).
## Подвох: reward model — не измеритель истины
Reward model не знает, что верно. Она лишь приближённо учится предсказывать человеческие предпочтения. Отсюда главная проблема: если она несовершенна, основная модель может начать оптимизироваться под её слабые места.
Иными словами, модель учится делать не то, что действительно лучше, а то, что **выглядит лучше для оценщика**. Например, reward model может слишком часто предпочитать длинные, уверенные и хорошо структурированные ответы — даже когда они не точнее коротких.
Это частный случай **reward hacking**: система находит способ получить высокий балл, не достигая настоящей цели.
## Ограничения и альтернатива: DPO
RLHF упирается в несколько вещей:
- человеческие оценки субъективны;
- разные оценщики предпочитают разные стили;
- reward model наследует эти предпочтения и смещения (biases);
- процесс дорогой: нужны люди, генерация множества ответов и дополнительное обучение.
Поэтому в лекции рядом обсуждается более простой метод — **DPO, Direct Preference Optimization**. Он учит модель напрямую на парах «предпочтительный ответ / отвергнутый ответ», без отдельной reward model и без полного RL-пайплайна с PPO.
| | SFT | RLHF | DPO |
|---|---|---|---|
| Какая обратная связь | Эталонные ответы | Ранжирование вариантов | Пары «лучше / хуже» |
| Отдельная reward model | Нет | Да | Нет |
| Алгоритм | Обычное дообучение | Обучение с подкреплением (PPO) | Прямая оптимизация по парам |
| Главная сложность | Дорого писать эталоны | Дорого и сложно настраивать | Качество пар предпочтений |
## Что из этого следует на практике
**1. Уверенный тон — не признак точности.** Модель обучена нравиться оценщикам, а людям нравятся ясные, структурированные, убедительные ответы. Красивое оформление и уверенность — повод проверить факты, а не расслабиться.
**2. Особенно в задачах, где ошибка дорого стоит.** RLHF может сделать ответы по юридическим, финансовым или медицинским темам яснее и аккуратнее, но **не гарантирует истинность**. Ответ, предпочтительный для человека, и фактически верный — не одно и то же. Ссылки на нормы, судебные решения, цифры и факты всё равно нужно проверять отдельно.
**3. Просите модель показывать основания.** Попросите ссылки на источники, отдельно отметить неуверенные места и разделить «известно» и «предполагаю». Это снижает эффект «выглядит убедительно» и облегчает проверку. Как формулировать такие правила, чтобы модель их держала, разобрано в [руководстве по промптингу](/blog/kak-promptit-fable-5-5-shagov/).
**4. Поведение моделей отличается не только знаниями.** Две модели с похожими знаниями ведут себя по-разному, потому что их учили на разных предпочтениях. Поэтому стоит тестировать модель на **своих** задачах, а не только смотреть рейтинги.
## Итог
**Pretraining** — модель умеет говорить и много знает. **SFT** — учится выполнять инструкции. **RLHF** — учится отвечать так, как предпочитают люди. И последнее — главное ограничение: «нравится людям» не равно «верно», поэтому проверку фактов никакая оптимизация под человеческие предпочтения не отменяет.
## Читайте также