Нейросети без обучения: как ИИ «размножается» и эволюционирует поколениями
Исследователи показали подход, где нейросети не обучают, а выращивают: популяция моделей конкурирует, скрещивается и мутирует без градиентного спуска. Как это работает и что меняет для создания ИИ.
Привычная картина создания нейросети такая: инженеры выбирают архитектуру, собирают данные, запускают обучение и тратят на него огромные вычислительные ресурсы. Каждый шаг — решение человека.
Недавно появилась работа с принципиально другой схемой: модели не обучают, а выращивают. Исследователи создают популяцию случайно инициализированных нейросетей и запускают между ними цифровую эволюцию по принципам естественного отбора. Градиентный спуск — основа почти всего современного обучения — в этой схеме не участвует вовсе.
Как устроена цифровая эволюция
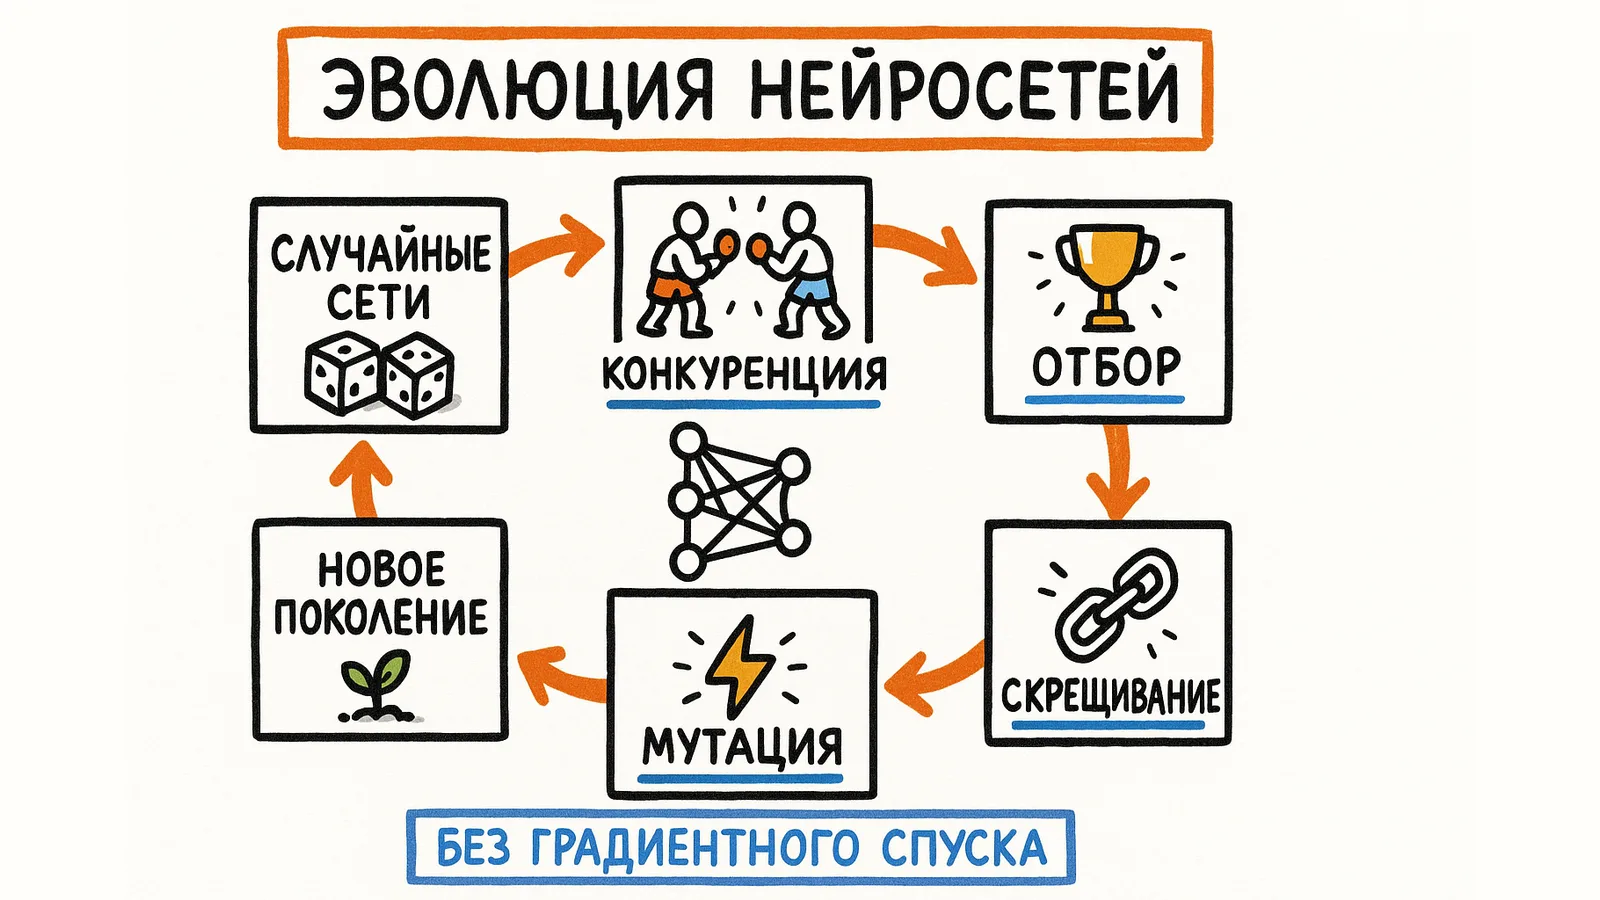
Схема повторяет биологию, только вместо организмов — наборы параметров нейросети:
flowchart TD
    A["Популяция случайных нейросетей"] --> B["Соревнование по заданному критерию"]
    B --> C["Отбор лучших"]
    C --> D["Скрещивание (crossover):\nпараметры двух моделей комбинируются"]
    D --> E["Мутации:\nслучайные изменения параметров"]
    E --> F["Новое поколение"]
    F --> B
    B -. "слабые модели" .-> G["Исчезают"]
Шаги по порядку:
- Случайность. Стартовая популяция — сети со случайными параметрами, сильных среди них нет.
- Конкуренция. Все модели решают задачу, их результат сравнивают по заданному критерию.
- Отбор. Лучшие получают право «размножаться». Выбирают модели с дополняющими друг друга способностями.
- Наследование. Параметры двух родителей комбинируются через crossover — получается «потомок», в котором есть свойства обеих моделей.
- Мутация. В потомка вносят небольшие случайные изменения — так в популяции появляется новое.
- Новое поколение. Цикл повторяется. Слабые модели исчезают, сильные передают параметры дальше.
От поколения к поколению система получает всё более эффективные сети — и всё это без единого шага градиентного спуска.
Идея не новая, но заслуживает внимания
Эволюционные алгоритмы для нейросетей — нейроэволюция — существуют с 1990-х. Работы вроде NEAT показывали, что сети можно выращивать отбором, а в 2017 году OpenAI показала, что эволюционные стратегии способны конкурировать с обучением с подкреплением на ряде задач. В 2024 году Sakana AI применила эволюцию к другому слою: подбирала рецепты слияния уже готовых моделей, получая новые без дообучения.
Чем интересна нынешняя работа: она возвращает этот подход в разговор о создании больших моделей. Подробности, масштаб экспериментов и сравнение с классическим обучением стоит смотреть в самой публикации — пересказ в соцсетях легко теряет оговорки. Поэтому ниже — о том, что следует из самой логики подхода, а не о цифрах.
Чем эволюция отличается от обучения
| Градиентное обучение | Эволюционный отбор | |
|---|---|---|
| Что нужно | Дифференцируемая функция потерь | Любой критерий «лучше / хуже» |
| Как улучшается | Шаг за шагом по направлению ошибки | Через популяцию вариантов и отбор |
| Размер вариантов | Одна модель | Тысячи моделей параллельно |
| Сильная сторона | Эффективность на больших данных | Свобода: можно оптимизировать то, что нельзя продифференцировать |
| Слабая сторона | Нужны архитектура и данные, выбранные человеком | Много вычислений на оценку каждого варианта |
Главное преимущество эволюции — свобода критерия. Градиентному спуску нужна гладкая функция ошибки. Эволюции достаточно уметь сравнить двух кандидатов: по результату в игре, по прибыли симуляции, по оценке эксперта. Там, где задачу нельзя записать формулой, отбор всё равно работает.
Главный минус — цена. Каждого «потомка» надо проверить, а проверка — это запуск модели. Поэтому пока подход не вытесняет классическое обучение, а расширяет набор инструментов. Масштабируется ли он до уровня современных языковых моделей — как раз то, что предстоит выяснить.
Почему это важно
Сегодня сильная модель — во многом управляемый людьми процесс: мы выбираем архитектуру, данные, схему тренировки. Эволюционный подход предлагает другой вопрос. Не «как обучить более умную модель», а «как создать среду, в которой более умные модели появляются сами».
Если подход масштабируется, смещается роль человека. Он перестаёт быть автором конкретной нейросети и становится автором правил отбора: что считать успехом, какие задачи ставить популяции, какие ограничения держать. А от качества этих правил зависит, что именно вырастет.
Для практики из этого следует то же, что и на каждой стадии развития ИИ: инструменты меняются быстро, а ценность остаётся у того, кто умеет сформулировать критерий. Критерий «хорошо» для отчёта, ответа клиенту или заявки с сайта придётся писать человеку и в мире, где модели отбираются автоматически. Если у вас он пока не сформулирован — это то, с чего стоит начать, даже если вы работаете с самыми обычными нейросетями. Как раз об этом — в разборе о том, что в бизнесе нельзя отдать ИИ.
Читайте также
 Пять стадий развития ИИ: от чат-ботов до сверхинтеллектана какой из пяти стадий развития ИИ мы сейчас и что это значит для бизнеса
 Как делают GPT и Claude: конвейер из 5 этапов простыми словамикак устроено классическое обучение моделей — с чем сравнивать эволюционный подход
 Мозг, сердце, руки: что в бизнесе нельзя отдать ИИкакие решения остаются за человеком, какой бы умной ни стала модель
🧭 Оценить свою маркетинг-готовностьБесплатно, в Telegram-боте @uspeshnyybot
Комментарии
Войдите через Telegram, чтобы оставить комментарий:
Пока нет комментариев. Будьте первым.