Маркетинговый инженер: как собрать систему, в которой агенты ведут кампании
Кто такой маркетинговый инженер и как собрать систему, где AI-агенты исследуют рынок, готовят брифы и учатся на результатах: рабочее пространство, знания, данные, первый workflow, тикеты и циклы проверки. Плюс готовый скилл, который собирает всё это за вас.
Когда маркетолог начинает всерьёз работать с агентами, быстро выясняется странная вещь. Задачи разные — исследовать рынок, спланировать кампанию, написать посты, собрать посадочную, — а агентам в каждой нужно одно и то же. Кому продаём. Что продаём. Что уже пробовали. Что показали результаты.
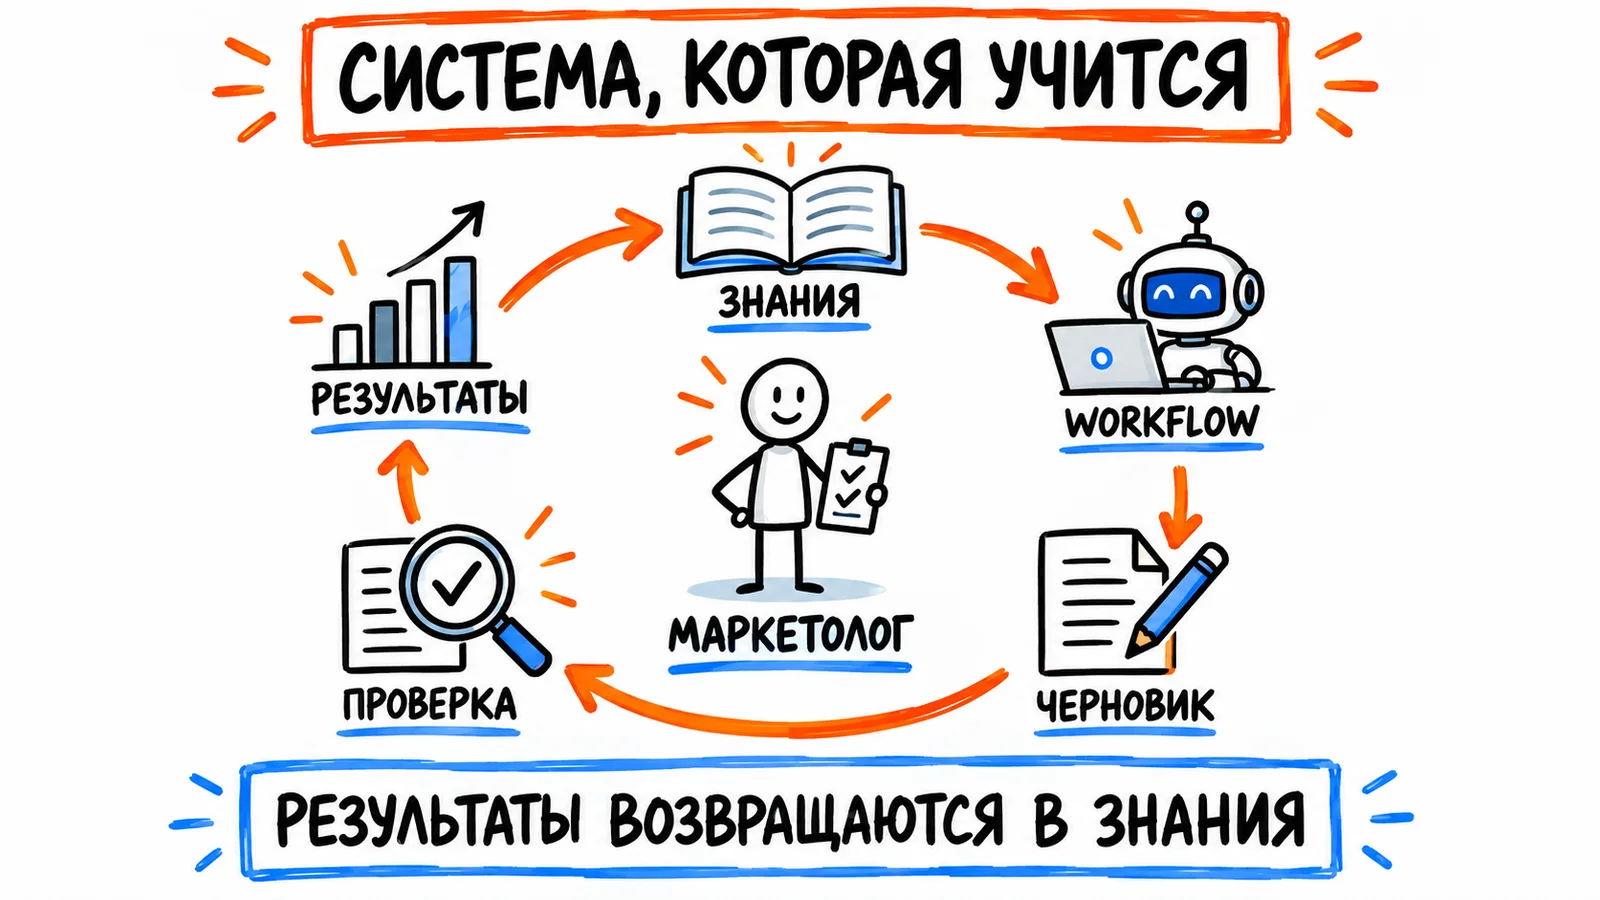
Пока эти сведения живут в голове и в переписке, каждую задачу приходится начинать с пересказа. Выход — перестать давать агентам разовые поручения и построить систему, в которой знания, данные и процессы связаны между собой.
Шанн Холмберг, который по его словам делает около 70% маркетинговой работы в агентной среде, назвал эту роль маркетинговым инженером и подробно описал подход в статье How to Become a Marketing Engineer. Ниже — разбор его подхода, пересобранный под российские инструменты. А в конце — скилл, который проводит через весь путь сам: задаёт вопросы, исследует, собирает данные, анализирует и создаёт структуру файлов.
Что в статье — три части
Подход. Кто такой маркетинговый инженер, рабочее пространство, подключения и доступы, слои знаний и данных, первый workflow, кампания в тикетах, циклы с лимитами.
Инструменты. Скилл, который собирает систему за вас, и витрина, чтобы показать её человеку.
Три живых проекта — если хочется сразу к практике:
- Медиа-кэмп ТЕЛЕМОРЕ: витрина пространства — 42 документа, 172 находки, 22 открытых вопроса.
- Продажа одного загородного дома: полный разбор — маркетинг делают двое, 203 находки до первого рубля рекламы.
- Клиника с двумя брендами: полный разбор — пациентский и B2B-бренд в одной базе знаний, главная находка — в собственных файлах.
В конце — все три проекта в одной таблице и короткий план, с чего начать.
Кто такой маркетинговый инженер
Это не программист в отделе маркетинга. Это маркетолог, который строит системы, делающие маркетинговую работу: на агентах, связанных данных и контексте бизнеса.
Например, контентная система. Она исследует темы, находит углы для кампании и создаёт материалы на основе исследования клиентов, оффера и голоса бренда. Вы проверяете результат до публикации. После публикации связанные процессы собирают результаты и возвращают их в базу знаний, чтобы следующая кампания начиналась не с нуля.
Главное здесь — ваша экспертиза. Именно вы решаете:
- что агентам нужно знать;
- какими источниками пользоваться;
- как проверять их работу;
- где без вашего участия нельзя.
Если предложения агента получились общими, это повод разобраться, а не переписать текст. Слишком широким было исследование? Не хватило знаний о клиентах? Инструкция упустила важное ограничение? Улучшать входы и инструкции — тоже часть работы над системой.
Роль собирает навыки с обеих сторон:
| Откуда навык | Что он даёт системе |
|---|---|
| Продуктовый маркетинг | Знания о клиенте, позиционировании и оффере |
| Контент и креатив | Голос, примеры, проверку созданных материалов |
| Performance-маркетинг | Процессы вокруг тестов и измеримых результатов |
| Маркетинговые операции | Связку инструментов и порядок передачи работы |
| Аналитика | Надёжные данные и проверку того, как агент их трактует |
| Разработка | Подключение API, код вместе с агентами, тестирование процессов |
Покрывать всё не нужно. Холмберг даёт простой совет: начинайте с работы, которую знаете. Если вы сильны в контенте — стройте с контента. Ваш опыт поможет выбрать источники, дать агентам хорошее направление и заметить, когда черновик промахнулся мимо сути.
Рабочее пространство: где живут знания и работа
Каждому проекту нужно место, где хранится контекст, запускаются процессы и сохраняется результат. Холмберг раскладывает его по маркетинговым направлениям, а общие знания о компании держит рядом, чтобы ими пользовались все направления:
marketing/
├── shared-knowledge/          общее: продукт, аудитория, позиционирование
├── content/
│   ├── knowledge/             знания направления: голос, примеры
│   ├── work/                  черновики и работа в процессе
│   ├── workflows/             процессы от входов до результата
│   ├── skills/  agents/  scripts-and-code/
│   ├── outputs/               одобренные материалы
│   └── results-and-learnings/ результаты и выводы
├── seo-aeo/
├── paid-and-creative/
├── lifecycle-and-cro/
└── outbound/
Строить всё сразу не нужно. Делаете контентный процесс — начните с папки контента и добавляйте то, что ему понадобится.
Одних имён папок агенту мало: они не объясняют, как работать. Нужен короткий файл-карта — где что лежит, какими источниками пользоваться, куда сохранять результат. Отдельные процессы потом ссылаются только на нужные им файлы. Это тот же приём, что и файл правил CLAUDE.md, только для маркетинга.
Подключения и доступы
Процессу нужны инструменты. Контентному — площадки, где искать посты и смотреть их результаты, и сервис, где создавать черновики. Подключаются они через API.
Начинать стоит с вопроса «что процесс должен сделать», а не «что можно подключить». И сразу разделять права:
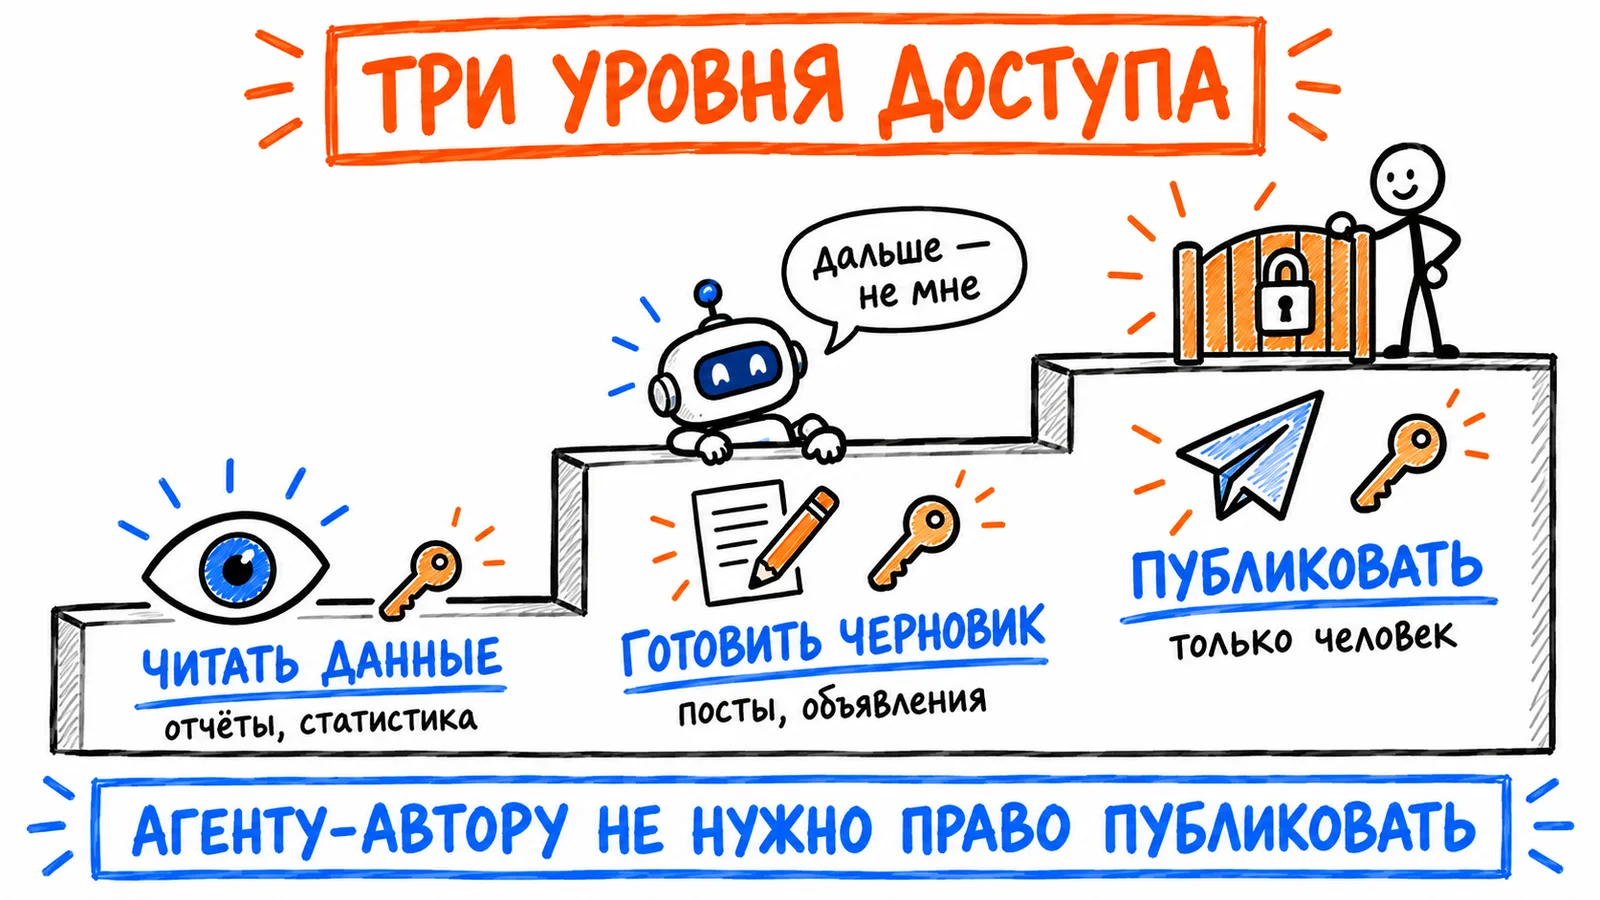
- Чтение данных, создание черновика и публикация — три разных уровня доступа. Процессу, который готовит посты на проверку, не нужно право публиковать.
- Одобрение — часть процесса. Если вы хотите видеть черновик до выхода, этот шаг вписан в workflow, а публикация закрыта там, где инструмент это позволяет.
- Ключи — только в файле
.env, исключённом из Git и не лежащем в общих папках. Не в промптах, не в брифах, не в файлах знаний. - Сначала маленький тест: забрать пару записей или создать один черновик. Потом подключать к остальной системе.
Не всё нужно подключать самим. Для свежих обсуждений темы Холмберг использует готовый скилл /last30days: он ищет, что люди в нише обсуждали за последний месяц в соцсетях, на форумах и в видео. Найденное всё равно проверяет человек.
Слой знаний: что бизнес знает и что происходит снаружи
Процессу нужно понимать аудиторию, оффер, цель и то, что уже пробовали. Холмберг делит этот контекст на внутренний и внешний:
| Внутренний контекст | Внешний контекст |
|---|---|
| Продукт, офферы, позиционирование | Продукты, офферы и кампании конкурентов |
| Звонки клиентов, заметки в CRM, переписка с поддержкой | Открытые обсуждения, отзывы, вопросы клиентов |
| Ваша экспертиза и примеры | Исследования рынка и отрасли |
| Прошлые кампании и их результаты | Поисковый спрос |
Сила — в соединении. Звонки показывают вопрос, который клиенты задают перед покупкой. Внешнее исследование показывает, как люди говорят об этой проблеме, что ищут и как её закрывают конкуренты. Вместе с данными о продукте и прошлых кампаниях у агента появляется материал для настоящих идей, а не общих слов.
Три правила слоя знаний:
- Ваша экспертиза тоже должна попасть в контекст. Голосовая заметка о том, почему прошлая кампания привела не тех клиентов, способна изменить следующий бриф. Причину своей правки стоит записать: «обещает результат, которого продукт не даёт» — это конкретная проверка для следующего запуска.
- У исследования есть источник и дата, у непроверенного — метка. Агент должен отличать одобренное решение о позиционировании от идеи, прозвучавшей на встрече. Как это устроено для голоса бренда, я разбирал в статье про голос бренда в AI-контенте.
- Исследование кампании живёт в её папке. Выводы, полезные дальше, после вашей проверки переносятся в общие знания.
Слой данных: связать рекламу с продажами
Чтобы планировать следующий раунд рекламы, агенту нужно знать, что было в прошлом: какие объявления привели посетителей, какие посетители оставили заявку, какие заявки стали продажами. В России это обычно Яндекс Директ и VK Реклама, Метрика и CRM вроде amoCRM или Bitrix24 — каждый со своими данными.
Хранилище сводит их в одно место, откуда процесс может делать запросы. Начать можно с маленькой базы SQLite и выгрузок в CSV. Дальше помогут три вещи:
- Регулярный сбор. Подключение к API само данные не обновляет. Нужен скрипт, который забирает новые записи по расписанию.
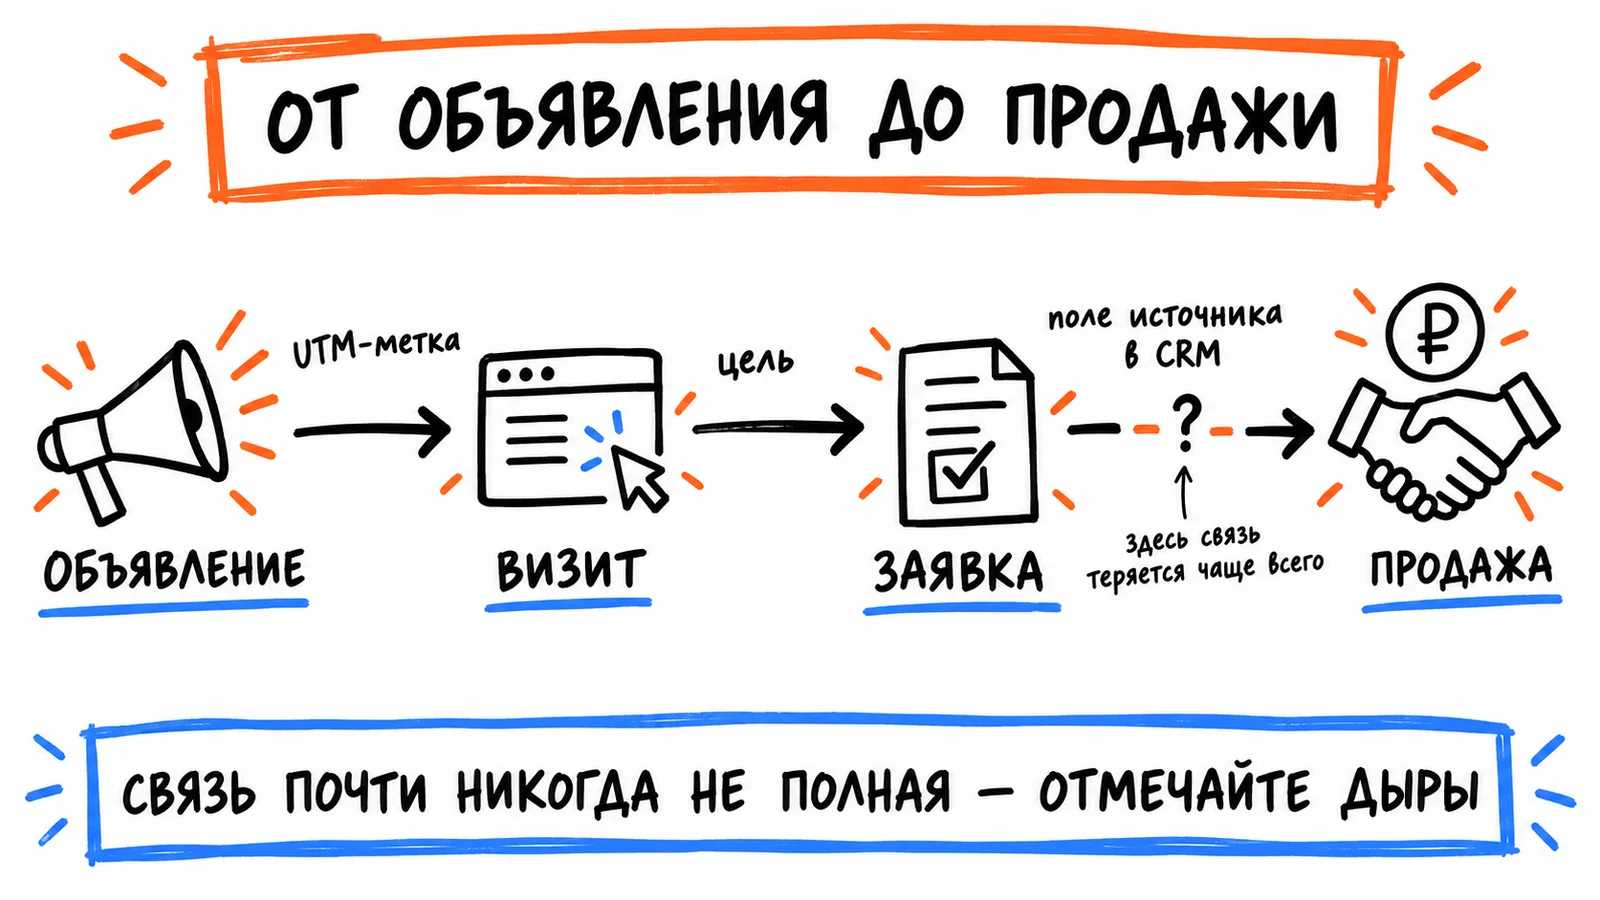
- Связка записей. ID кампаний показывают, что крутилось. UTM-метки — откуда пришёл визит. Поле источника в CRM — откуда пришла заявка.
- Честность про дыры. Связка почти никогда не бывает полной. Процесс должен сообщать о пропущенной разметке, а не уверенно приписывать каждую продажу.
Начинать стоит с вопроса, на который нужен ответ. Например: «какие углы в рекламе принесли качественные заявки в прошлом месяце и что тестировать дальше?» Для ответа мало кликов: нужны расход, исход заявок и запись о том, какой угол проверяло каждое объявление. А ваш разбор добавит то, чего не видно в цифрах: заявки обработали поздно, оффер поменяли посреди кампании, одно объявление обещало лишнее и привело не тех клиентов.
Первый workflow
Выберите задачу, которую делаете достаточно часто, чтобы узнать хороший результат. Для рекламы это может быть бриф на следующий раунд креативов по исследованию клиентов и прошлым результатам. Публикацию объявлений и изменение бюджетов — позже.
Холмберг не запускает процесс сразу. Сначала он 5–10 минут надиктовывает всё, что знает о задаче: цель, контекст, что уже пробовал, в чём не уверен. Потом прорабатывает это с агентом через скиллы планирования Мэтта Покока, которые допрашивают вас по дереву решений. Здесь уходит время на ответы: если агент спрашивает, что считать качественной заявкой, от ответа зависит, какие результаты он возьмёт. А если оффер не согласован, генерировать креативы рано.
Дальше процесс запускается с вашим участием. Если исследование конкурентов нерелевантно, чинятся критерии отбора до того, как оно попадёт в бриф. Если направления игнорируют возражение клиента, проверяется, было ли оно в знаниях и просила ли инструкция его учесть. Когда процесс сложился, шаги сохраняются как переиспользуемый workflow.
Лучше всего видно, что улучшать, в местах, где пришлось вмешаться:
| Что случилось | Где искать причину |
|---|---|
| Исследование захватило нерелевантные компании | Критерии отбора и инструкции исследования |
| Рекомендации упустили важное возражение клиента | Контекст о клиентах в знаниях |
| Отчёт взял старые цифры | Обновление данных и проверка свежести |
| Результат выглядит правильно, но бесполезен | Бриф и определение хорошего результата |
Кампания целиком: тикеты вместо хаоса
Холмберг честно признаётся: раньше он переусложнил свою контентную систему. Четыре агента на то, что по сути было тремя шагами производства и петлёй обратной связи. Лучше контекст для агента-автора дал больше, чем новые агенты.
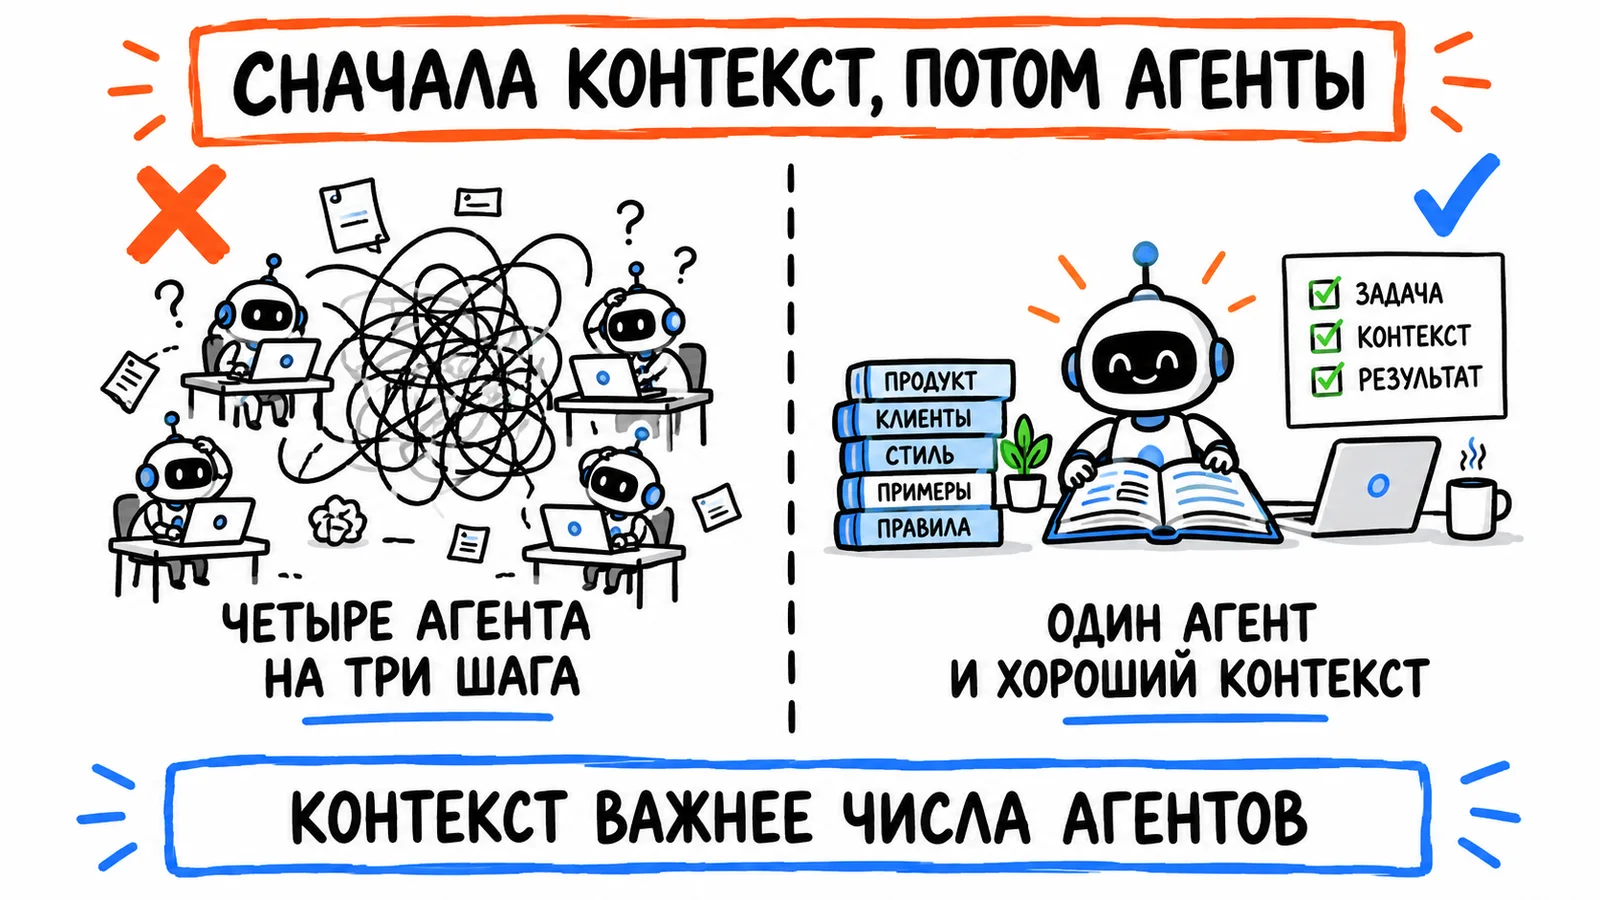
Это тот же вывод, к которому приходят исследования: команда агентов окупается только там, где задача действительно раскладывается на независимые части. Как выбирать форму — в разборе шести паттернов оркестрации.
Для многоканального запуска — посадочная, реклама, контент, письма — Холмберг сначала планирует кампанию целиком, а потом режет её на тикеты. Каждый тикет описывает результат, ссылается на нужный контекст, перечисляет проверки и фиксирует зависимости:
| Тикет | Зависит от | Статус |
|---|---|---|
| Утвердить оффер кампании | Исследование клиентов и конкурентов | Нужно решение |
| Собрать посадочную | Одобренный оффер и campaign book | Ждёт |
| Подготовить рекламные креативы | Одобренный оффер и campaign book | Ждёт |
| Проверить связку объявление — посадочная | Посадочная и креативы | Ждёт |
Параллельно можно вести исследование конкурентов, разбор прошлых кампаний и поиск потенциальных клиентов. Последовательно — всё, что зависит от решений: финальный текст ждёт согласованного оффера, реклама — посадочную, письма — понимания, на что человек подписался.
Общий визуальный ориентир — campaign book: мудборд и одобренные примеры для объявлений, страниц, постов и писем. Холмберг собирает его в Paper или Figma. Агенты по нему верстают макеты в коде и делают варианты под форматы, а человек проверяет направление и детали продукта.
И последнее: проверять кампанию целиком, а не только отдельные материалы. Каждый может пройти свои проверки и при этом противоречить другим. Обещает ли объявление то, что даёт посадочная? Тот же ли оффер в письме? Совпадают ли даты и ссылки?
flowchart TD
    A["Общие знания<br/>аудитория и оффер"] --> C["Запуск workflow"]
    B["Контекст кампании<br/>бриф и исследование"] --> C
    C --> D["Черновики<br/>и проверки"]
    D --> E["Ваша проверка"]
    E -->|правки| C
    E -->|одобрено| F["Готовые материалы"]
    F --> G["Результаты кампании"]
    G --> H["Выводы и ваш разбор"]
    H --> A
Циклы: работать до результата, но с лимитами
Когда у процесса есть понятные шаги и проверки, агент может повторять часть работы, пока результат не пройдёт требования. Это цикл. Для набора креативов проверки простые: верные ли размеры, не обрезан ли текст, совпадает ли оффер с посадочной, точны ли детали продукта. Не прошло — конкретные правки и снова проверка.
Цель для цикла должна называть результат, указывать на план и говорить, когда остановиться. «Сделай креативы лучше» агенту ничего не даёт. Холмберг использует команду /goal: сама цель короткая, а исследование, требования и решения лежат в файлах. По-русски это выглядит так:
Подготовь бриф для следующего раунда рекламы.
Контекст: audience.md, approved-claims.md, campaign-book/
и previous-test-results.md.

Предложи 3 направления. Для каждого: для кого, на чём основано,
чем отличается от прошлых тестов. Дай ссылки на источники,
отметь допущения. Проверь каждое по аудитории и одобренным обещаниям.
Сохрани в creative-brief.md в папке кампании.

Остановись, когда бриф готов к моей проверке.
Не создавай и не публикуй объявления. Если не хватает контекста — спроси.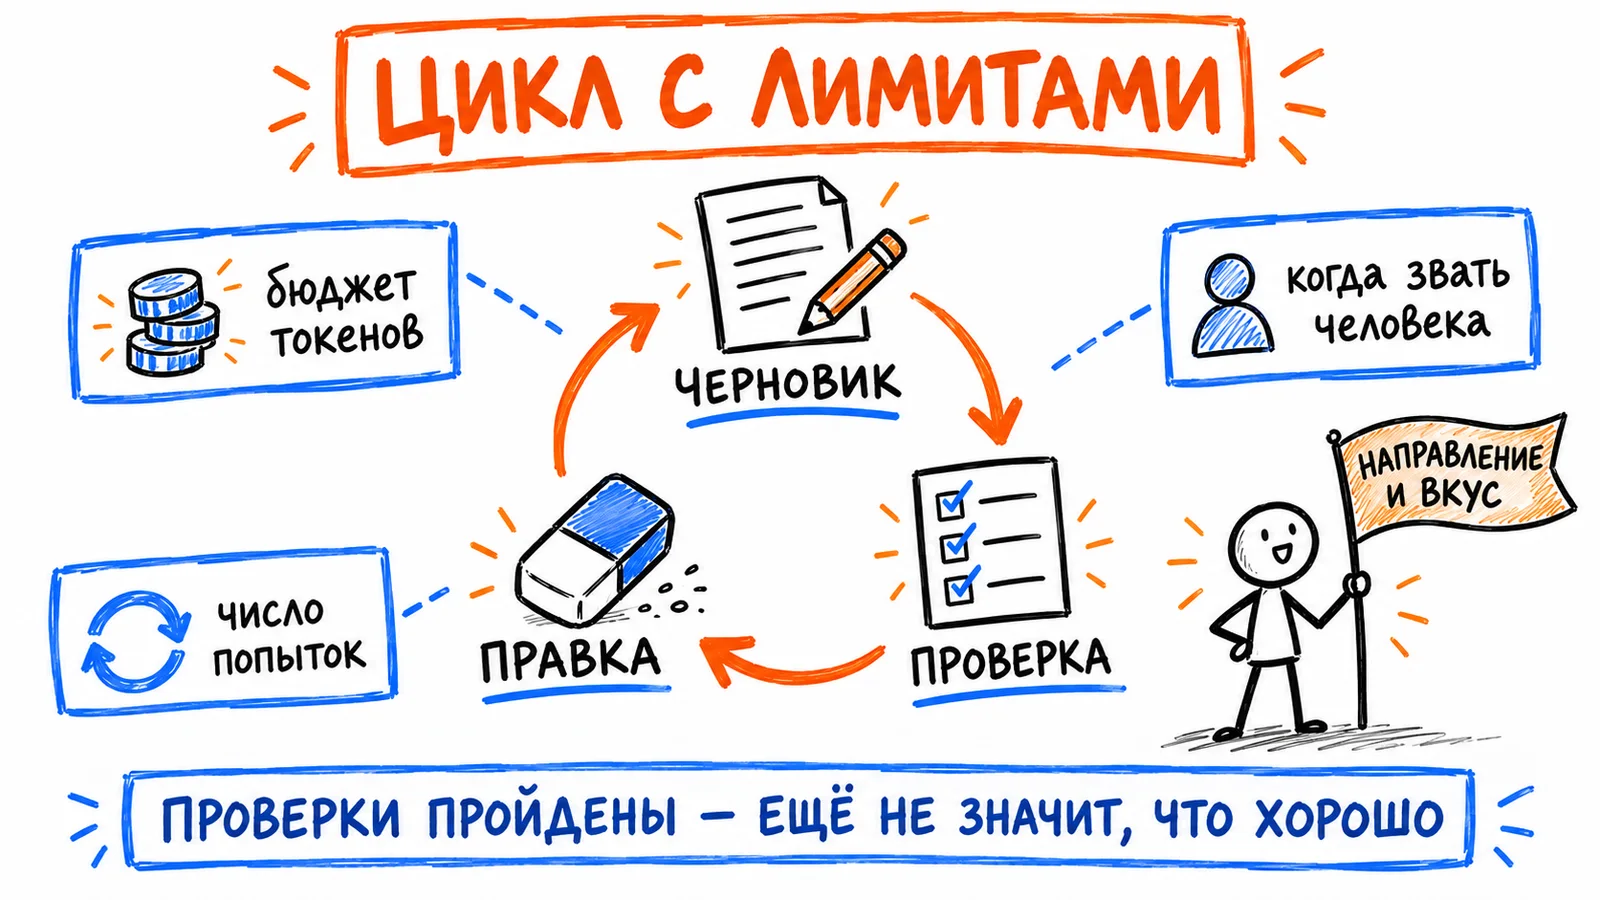
У цикла обязательны лимиты: время или бюджет токенов, число попыток и правило, когда звать человека. И важная оговорка Холмберга: пройденные проверки не значат, что креатив понравится. Размеры проверяются автоматически, направление и вкус — человеком.
Регулярные задачи и боты
Часть работы повторяется: обновить данные кампаний, проверить активность конкурентов, собрать недельный отчёт. Когда процесс справляется с задачей надёжно, её можно поставить на расписание.
Но расписание не чинит недоделанный процесс. Сначала задача проходит вручную: к чему у неё доступ, что она производит, как проверить результат и что делать при сбое. Отчёт должен сообщать о неудачном обновлении данных, а не писать уверенные выводы на цифрах прошлой недели. Как ловить такие тихие отказы — в статье как следить за AI-ботом в работе.
Следующий шаг — бот, которому команда даёт работу прямо в рабочем чате: «разбери результаты рекламы за прошлую неделю и подготовь бриф для следующего теста». Но создавать его стоит только тогда, когда у него есть понятная работа.
📊 Собрать анализ рынка и конкурентовБесплатно, в Telegram-боте @uspeshnyybotСкилл, который собирает всё это за вас
Прочитать про систему легко, собрать — долго. Поэтому я упаковал подход в скилл для AI-агентов: он работает в Claude Code, Codex, Cursor и других средах, которые поддерживают формат Agent Skills.
Он проводит через шесть фаз:
- Задаёт вопросы. Раундами, по дереву решений, к каждому вопросу — рекомендуемый ответ. Сначала смотрит сайт, чтобы не спрашивать то, что там уже написано.
- Исследует. Сайт компании, конкурентов, отзывы и обсуждения клиентов. У каждой находки источник, дата и метка: факт, предположение или «проверить».
- Собирает данные. Составляет инвентарь источников и загружает выгрузки из Директа, Метрики или CRM в SQLite. Кодировку (включая cp1251) и разделитель определяет сам и отмечает дыры в связке данных.
- Анализирует. Аудитория с возражениями, карта конкурентов, пробелы и три направления для первой задачи. Выбор оставляет вам.
- Создаёт структуру и файлы. Общие знания, стартовое направление, кампанию с тикетами, первый workflow, цели для запуска и проверки.
- Проверяет. Ищет незаполненные поля, похожие на ключи строки, находки без источника и битые ссылки между файлами.
Правила у него жёсткие: ничего не публикует и не отправляет, не просит ключи в чате, не выдумывает цифры и отзывы, не перезаписывает существующие файлы. Решения — направление, обещания клиентам, что требует одобрения — остаются за человеком.
Установка — одной командой:
npx skills add ircitdev/marketing-engineer-skillИли скопируйте папку skills/marketing-engineer в .claude/skills/ проекта. Запускается обычной фразой: «Собери маркетинговое рабочее пространство для агентов. Компания — …, сайт …, начнём с контента, первая задача — …».
Не готовы ничего устанавливать — начните с того, что скилл делает на этапах исследования и анализа. Бот соберёт анализ рынка и конкурентов по адресу вашего сайта: где прячутся деньги и что обещают другие.
📊 Собрать анализ рынка и конкурентовБесплатно, в Telegram-боте @uspeshnyybot
Как показать пространство человеку
Когда пространство собрано, обнаруживается неудобная вещь. Агенту в нём хорошо: плоские markdown-файлы, короткие, со ссылками друг на друга — он читает ровно те, что нужны задаче. А человеку — нет.
Заказчик не станет клонировать репозиторий, чтобы прочитать позиционирование. Менеджер не найдёт скрипт обзвона в папке outbound/outputs/. Вы сами через месяц забудете, в каком файле осталось незакрытое решение. Знания, которые никто не открывает, довольно быстро перестают быть знаниями.
Поэтому к пространству нужна витрина — одна страница, на которую можно дать ссылку.
Живой пример: медиа-кэмп ТЕЛЕМОРЕ
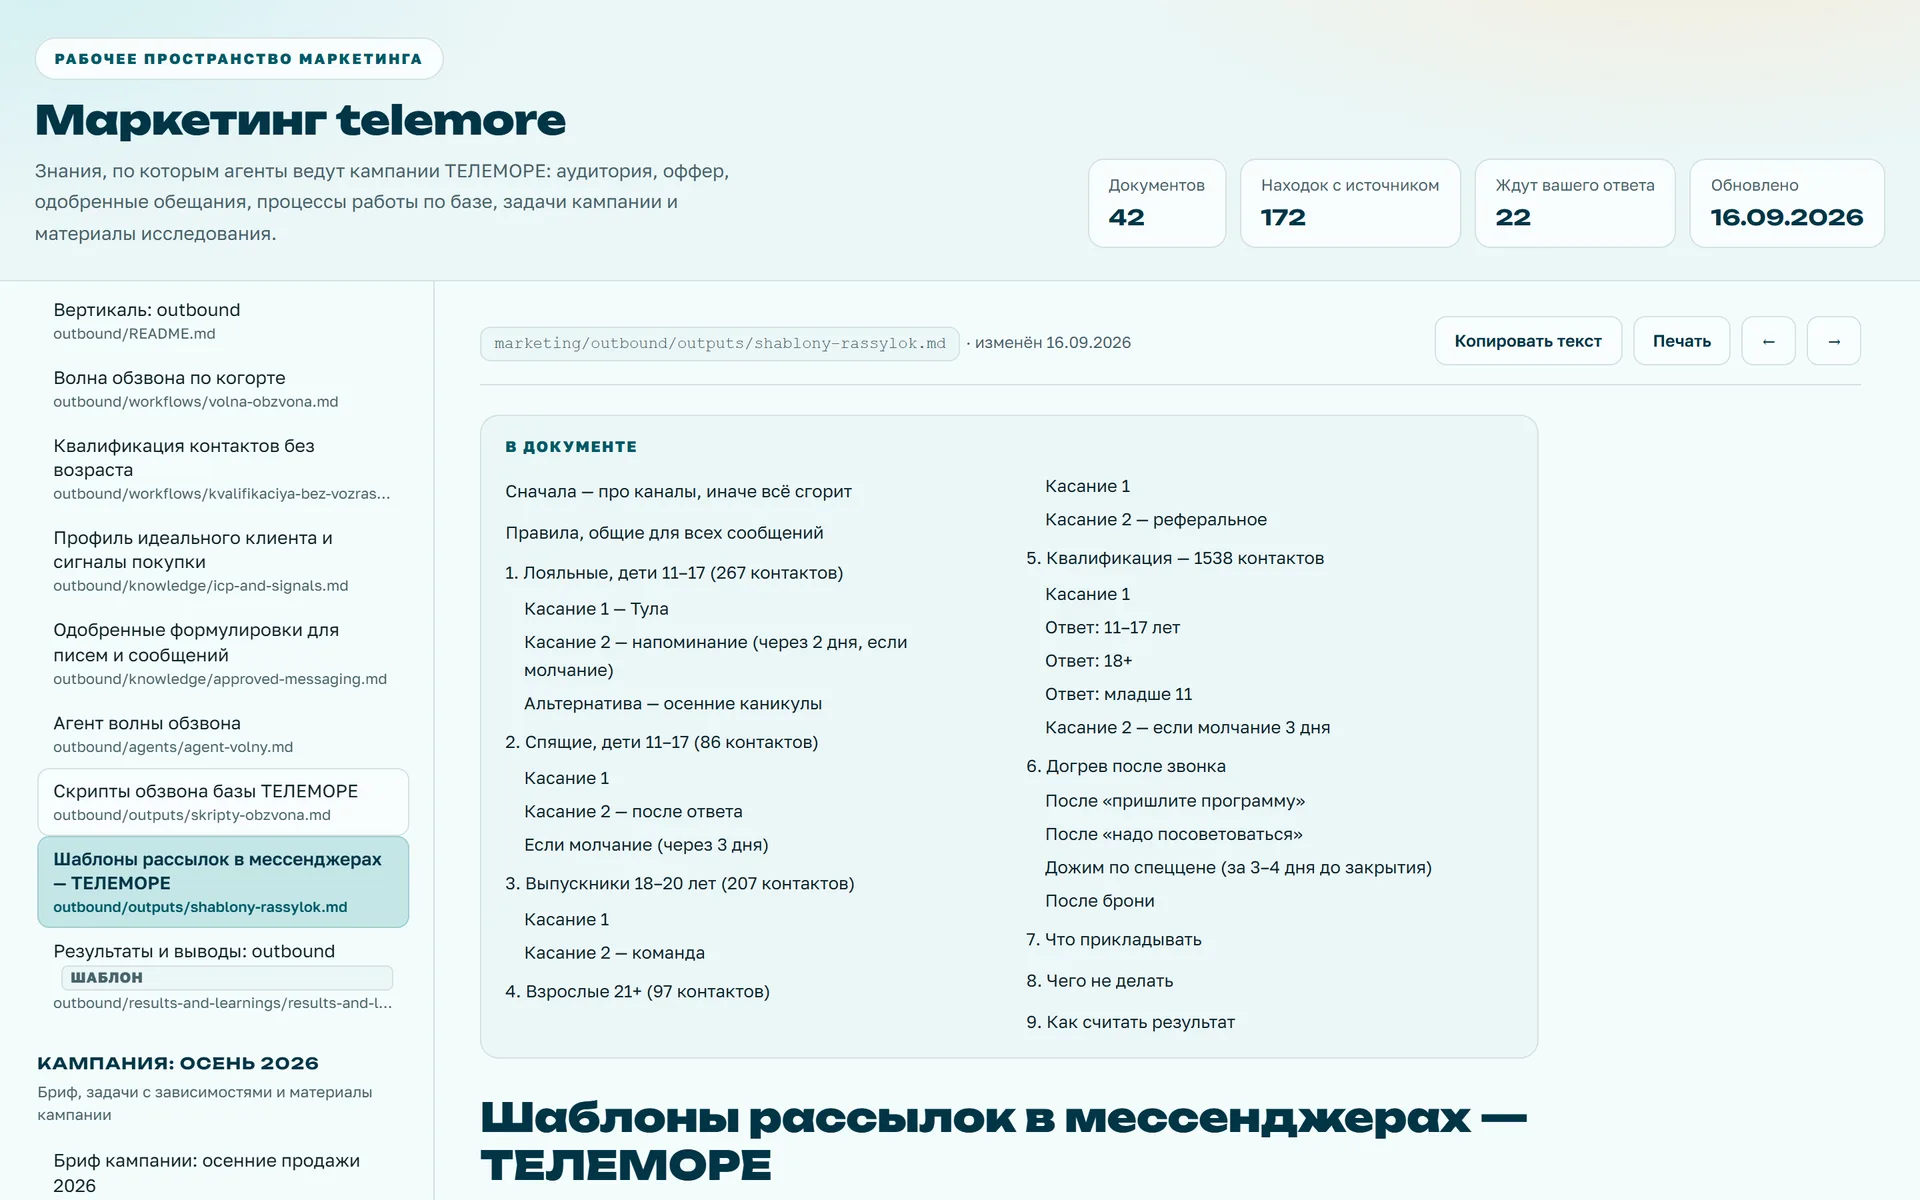
Медиа-кэмп ТЕЛЕМОРЕ, пространство собрано скиллом маркетингового инженера.
Внутри 42 документа: аудитория, оффер, одобренные обещания, процессы работы по базе на 2426 контактов, семь задач кампании с зависимостями и 172 находки исследования — каждая с источником, датой и меткой достоверности.
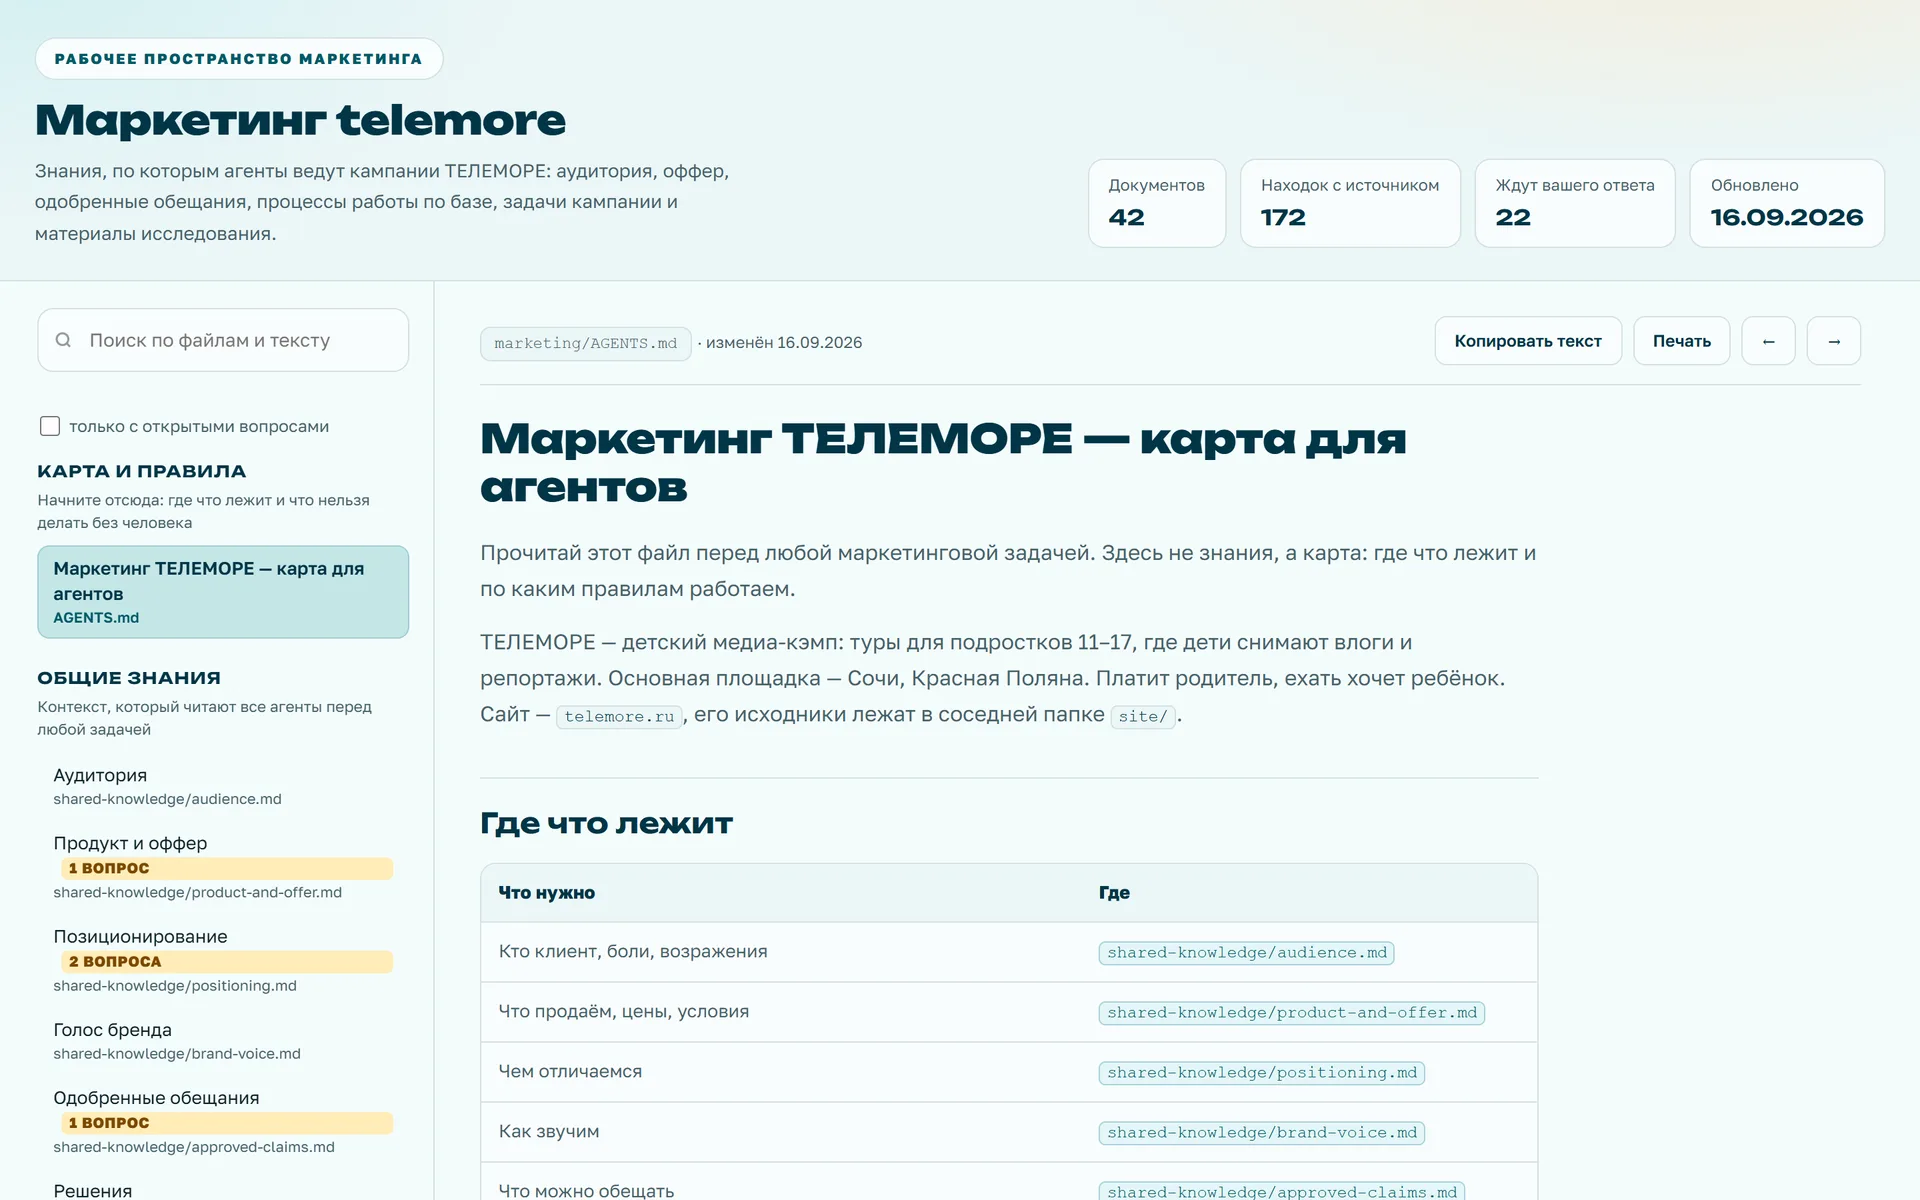
Что там стоит посмотреть, кроме содержания:
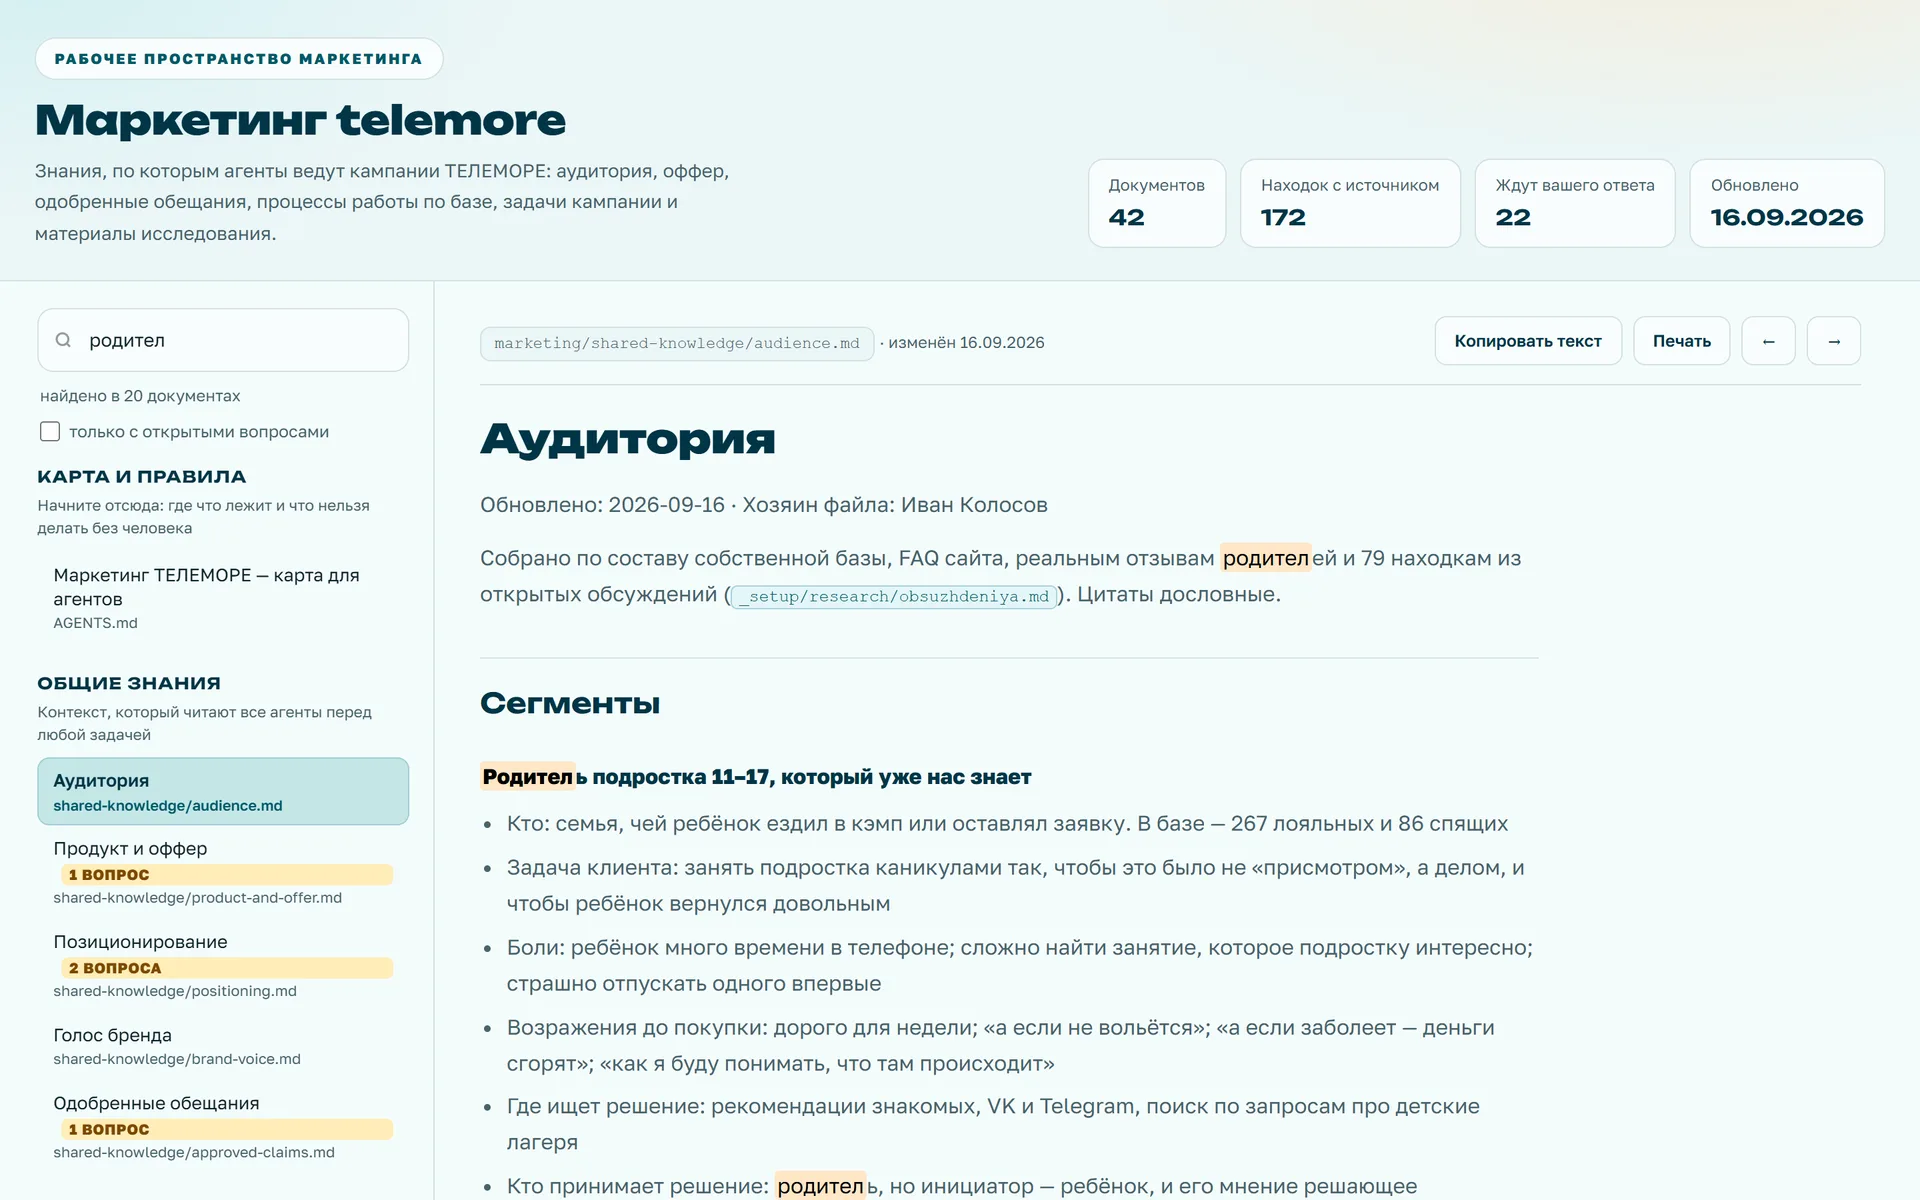
- Открытые вопросы видно сразу. Места, где нужен ответ владельца, подсвечены плашками, в шапке счётчик, в меню фильтр «только с открытыми вопросами». Сейчас их 22 — это готовая повестка встречи, а не поиск по файлам.
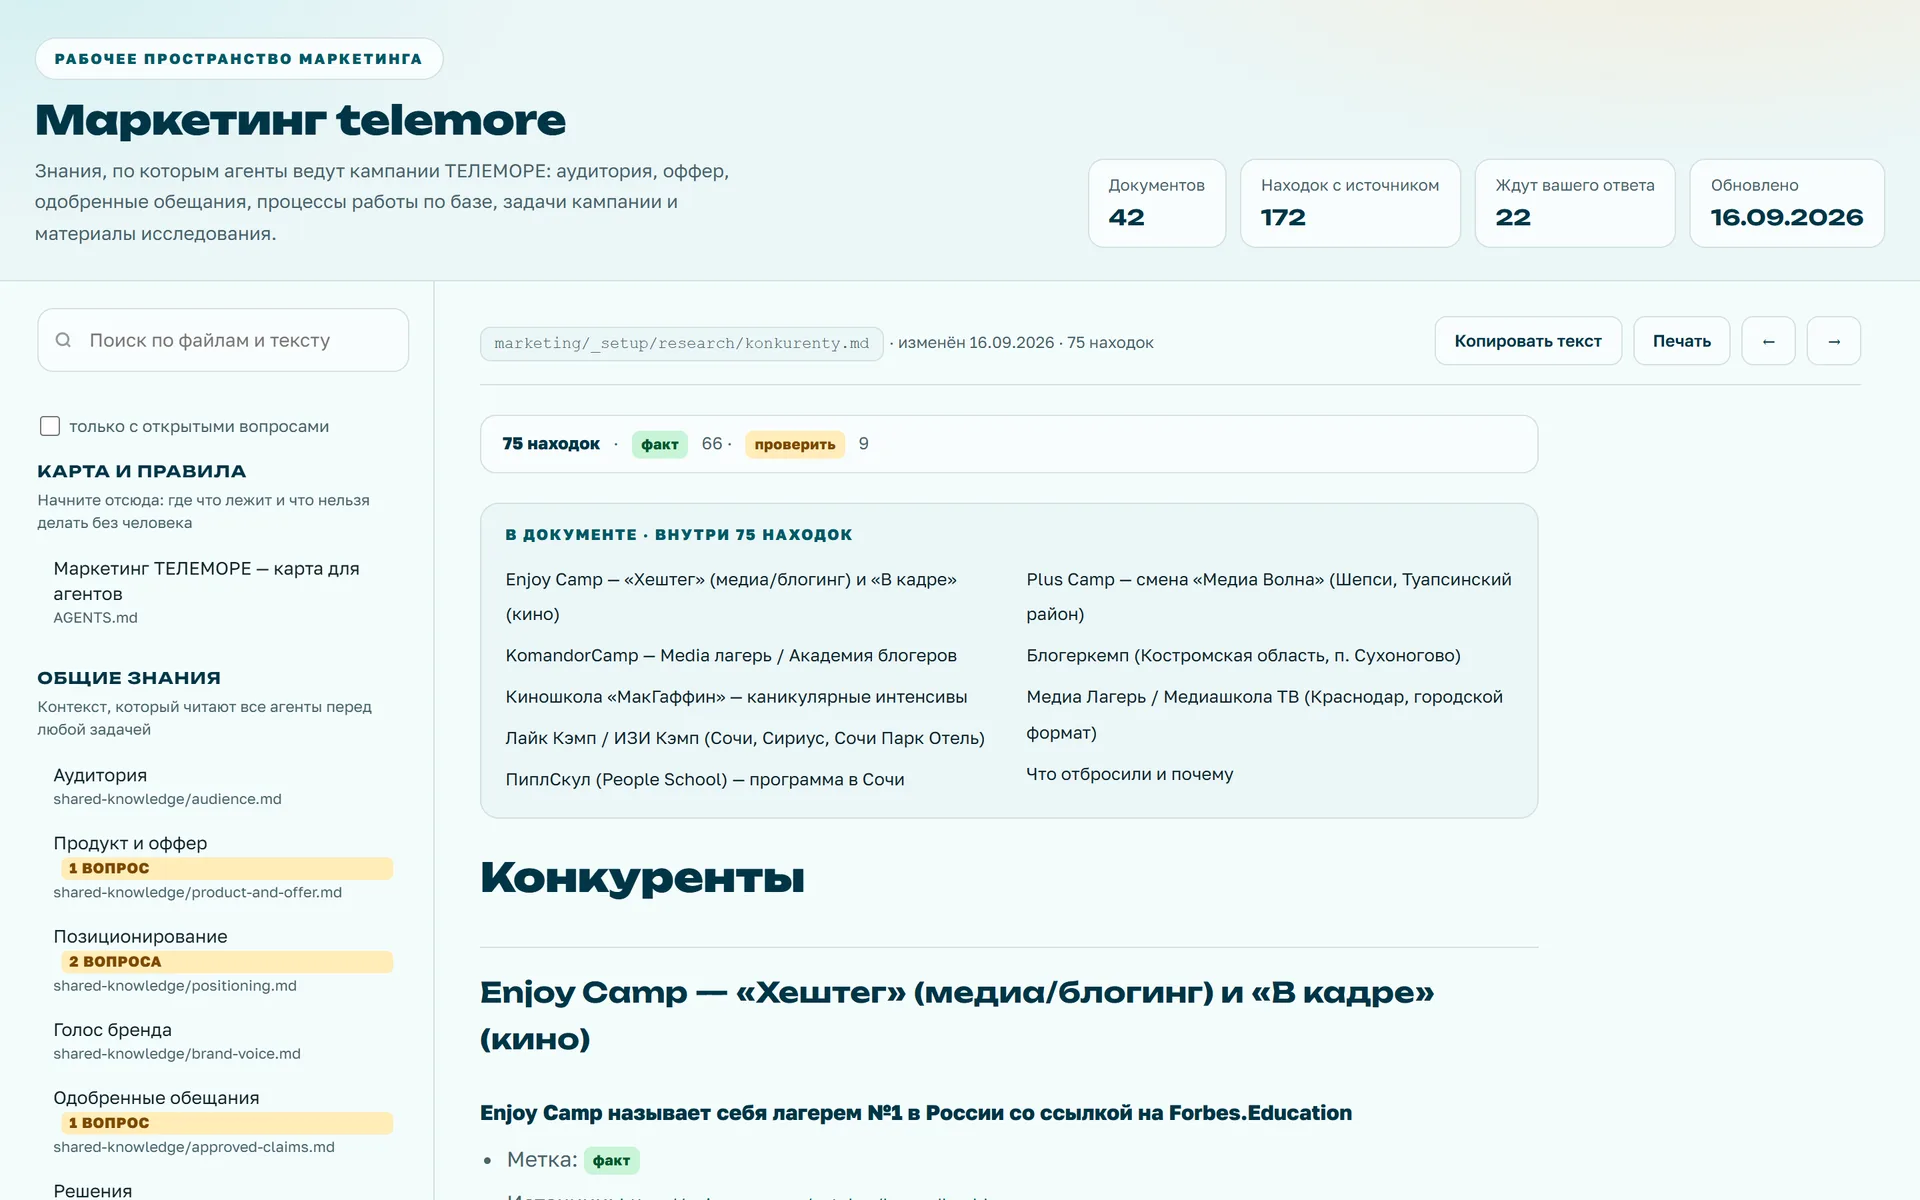
- Достоверность честная. У файлов исследования строка вида «75 находок · факт 66 · проверить 9». Видно качество данных, не читая текст.
- Пустое остаётся пустым. Заготовки под результаты помечены бейджем «шаблон»: цифры появятся после первой волны, и врать об этом незачем.
- Поиск идёт по всему тексту, а не по названиям файлов, и подсвечивает найденное.
Скилл для витрины
Страница собирается из тех же файлов, поэтому разойтись с исходниками не может. Это отдельный скилл, который запускается после маркетингового инженера:
npx skills add ircitdev/marketing-page-skillДальше обычными словами: «собери страницу маркетингового пространства».
Он делает оглавление длинным документам, превращает пути в бэктиках и адреса источников в рабочие ссылки, показывает дату изменения каждого файла, добавляет клавиши, кнопку «наверх» и стили печати в PDF. На выходе — один HTML-файл, которому нужна только раздача статики.
Отдельным разделом скилл подтягивает бренд-материалы из папки VisualCode: визуальный лист, стандарт и промпт пересборки. Стандарт разворачивается в палитру плитками с настоящим цветом, а скрипт сверки читает CSS сайта и показывает, где стандарт с кодом разошёлся. На ТЕЛЕМОРЕ это сразу дало результат: шрифты в стандарте были угаданы по скриншотам неверно, а один акцентный цвет в коде не встречается вовсе.
Одно предупреждение
Такая страница по умолчанию доступна каждому, у кого есть ссылка. Внутри пространства лежат рабочие материалы: скрипты разговора с клиентом, сегменты, иногда контакты сотрудников.
Скилл исходит из того, что страница публичная: телефоны на ней маскируются, выгрузки с персональными данными в сборку не попадают, стоит запрет индексации. Но решение, закрывать ли витрину паролем, остаётся за вами — и принять его лучше до того, как вы отправите ссылку в общий чат.
Пример: система на реальном проекте — и страница, которую можно открыть
Теория выше звучит как про большие команды. Покажу, как скилл отработал там, где «отдел маркетинга» — это собственник и я. И сразу дам ссылку: так выглядит собранное пространство.
Паспорт проекта
- Что: сайт и Telegram-агент для продажи одного загородного дома напрямую от собственника.
- Кто ведёт маркетинг: собственник и исполнитель.
- Интервью: 7 вопросов исполнителю, 10 — собственнику.
- Исследование: 203 находки за сорок минут, три субагента.
- Витрина: 22 документа, 84 места ждут ответа.
- Первая находка: рекламные заготовки под другой дом, по старой цене и с обещанием, которого нет.
- Ушло: вечер. Реклама не запущена — ждём ответов собственника.
dubldom2026.ru — сайт и Telegram-агент для продажи одного загородного дома напрямую от собственника. Бот отвечает покупателю, считает ипотеку, записывает на показ в календарь и напоминает о себе тем, кто замолчал. Техническая часть готова и проверена, а вот рекламы нет — до бота почти никто не доходит. Первая задача очевидна: запустить трафик. И именно здесь проще всего сжечь бюджет: открыть рекламный кабинет и написать объявления по памяти.
Вместо этого я запустил скилл.
flowchart TD
    A["Материалы проекта<br/>сайт, база знаний бота, документы"] --> B["Интервью<br/>7 вопросов мне, 10 — собственнику"]
    B --> C["Исследование<br/>3 субагента параллельно"]
    C --> D["203 находки<br/>источник, дата, метка"]
    E["Данные сайта и бота"] --> F
    D --> F["Пространство marketing/"]
    F --> G["Страница-витрина<br/>для собственника и для меня"]
    F --> H["Кампания: объявления → Директ → VK"]
Интервью: сначала прочитать, потом спрашивать
Прежде чем задать первый вопрос, скилл прошёл по материалам проекта и записал в _setup/interview.md всё, что уже известно: объект, цену, статус дома, стратегию, какие данные есть. Поэтому в первом раунде осталось семь вопросов — и к каждому рекомендуемый ответ. Мне хватило одной фразы: «всё как предлагаешь».
Уже на этом шаге нашлась первая мина. В репозитории лежали майские заготовки для Яндекс.Директа и объявления на площадке — под другой дом, по старой цене и с уточнением «Готов к заезду». Дом, который продаётся сейчас, ещё в производстве. Запусти мы рекламу из старой папки — первые же звонки упёрлись бы в обещание, которого нет.
Второй раунд — десять вопросов собственнику. Такие, на которые не ответит ни один агент: когда закончится сборка, как будет оформляться сделка, какая категория земли, какой бюджет и кто одобряет тексты перед публикацией.
Исследование: три субагента и честные метки
Конкурентов, обсуждения покупателей и поисковый спрос скилл отдал трём субагентам параллельно — у каждого свой контекст, общий формат находки. Через сорок минут в _setup/research/ лежало 203 находки:
| Метка | Сколько | Что значит |
|---|---|---|
| Факт | 159 | Проверяемый источник, находка прямо из него |
| Проверить | 43 | Один отзыв, старая дата, реклама или текст получен автоматически |
| Предположение | 1 | Источника нет |
Что вошло: выдача площадки объявлений по посёлку и 141 дом на том же направлении, сайты производителей и соседних посёлков, отзывы и комментарии покупателей, поисковые подсказки, правила ипотечных программ и свежая аналитика рынка.
Две вещи мне понравились больше всего.
Отброшенное тоже записано. Цифра «спрос на загородные дома вырос на 45%» из федерального СМИ ушла с меткой «проверить» и пометкой «не использовать»: у неё нет источника. Без меток она легко перекочевала бы в объявление.
Закрытое не обходилось. Одна площадка не открылась, у другой антибот, поиск отдал капчу. Субагенты ничего не взламывали — записали, что именно не проверено и что нужно посмотреть руками из браузера.
Данные: ноль тоже результат
Своих данных у проекта немного: трекер визитов сайта и база бота. За полмесяца — 53 просмотра сайта, 6 нажатий «Записаться», ноль визитов с рекламной меткой, единственная заявка тестовая. Выгрузки из системы аналитики нет. Скилл не стал рисовать из этого воронку: в _setup/data-inventory.md это записано как дыры, которые закроет только запуск.
Что это дало до первого рубля
- Сравнение глазами покупателя. Выдача по посёлку показала, с какими домами и ценами покупатель будет сравнивать наш, — значит, объявление должно с первой строки объяснять разницу.
- Сверка обещаний. Между объявлением на площадке и сайтом нашлись расхождения, а формулировки про ипотеку потребовали сверки с правилами программы и банком. Реклама на неподтверждённом обещании приводит людей к отказу — и это худший первый контакт.
- Слова покупателей. Страхи каркасного дома, счета за электричество без газа, ипотека на дом, который ещё строится, школа в 60 км от Москвы — дословными цитатами. Готовые возражения для текстов и FAQ.
- Семантика и минус-слова. Подсказки показали, что рядом с «барнхаус в Подмосковье» живёт огромный арендный спрос — «снять посуточно», — а «дом от собственника» почти всегда идёт в паре с «недорого». Для дома за 12,9 млн это список минус-слов ещё до создания кампании.
Витрина: одна страница вместо папки с файлами
Пространство marketing/ удобно агентам: плоские markdown-файлы, которые машина читает без подготовки. Человеку нужна другая форма — одна страница, где видно всё сразу.
Её собирает тот же скилл витрины, что описан выше, — читает те же файлы и делает из них HTML.
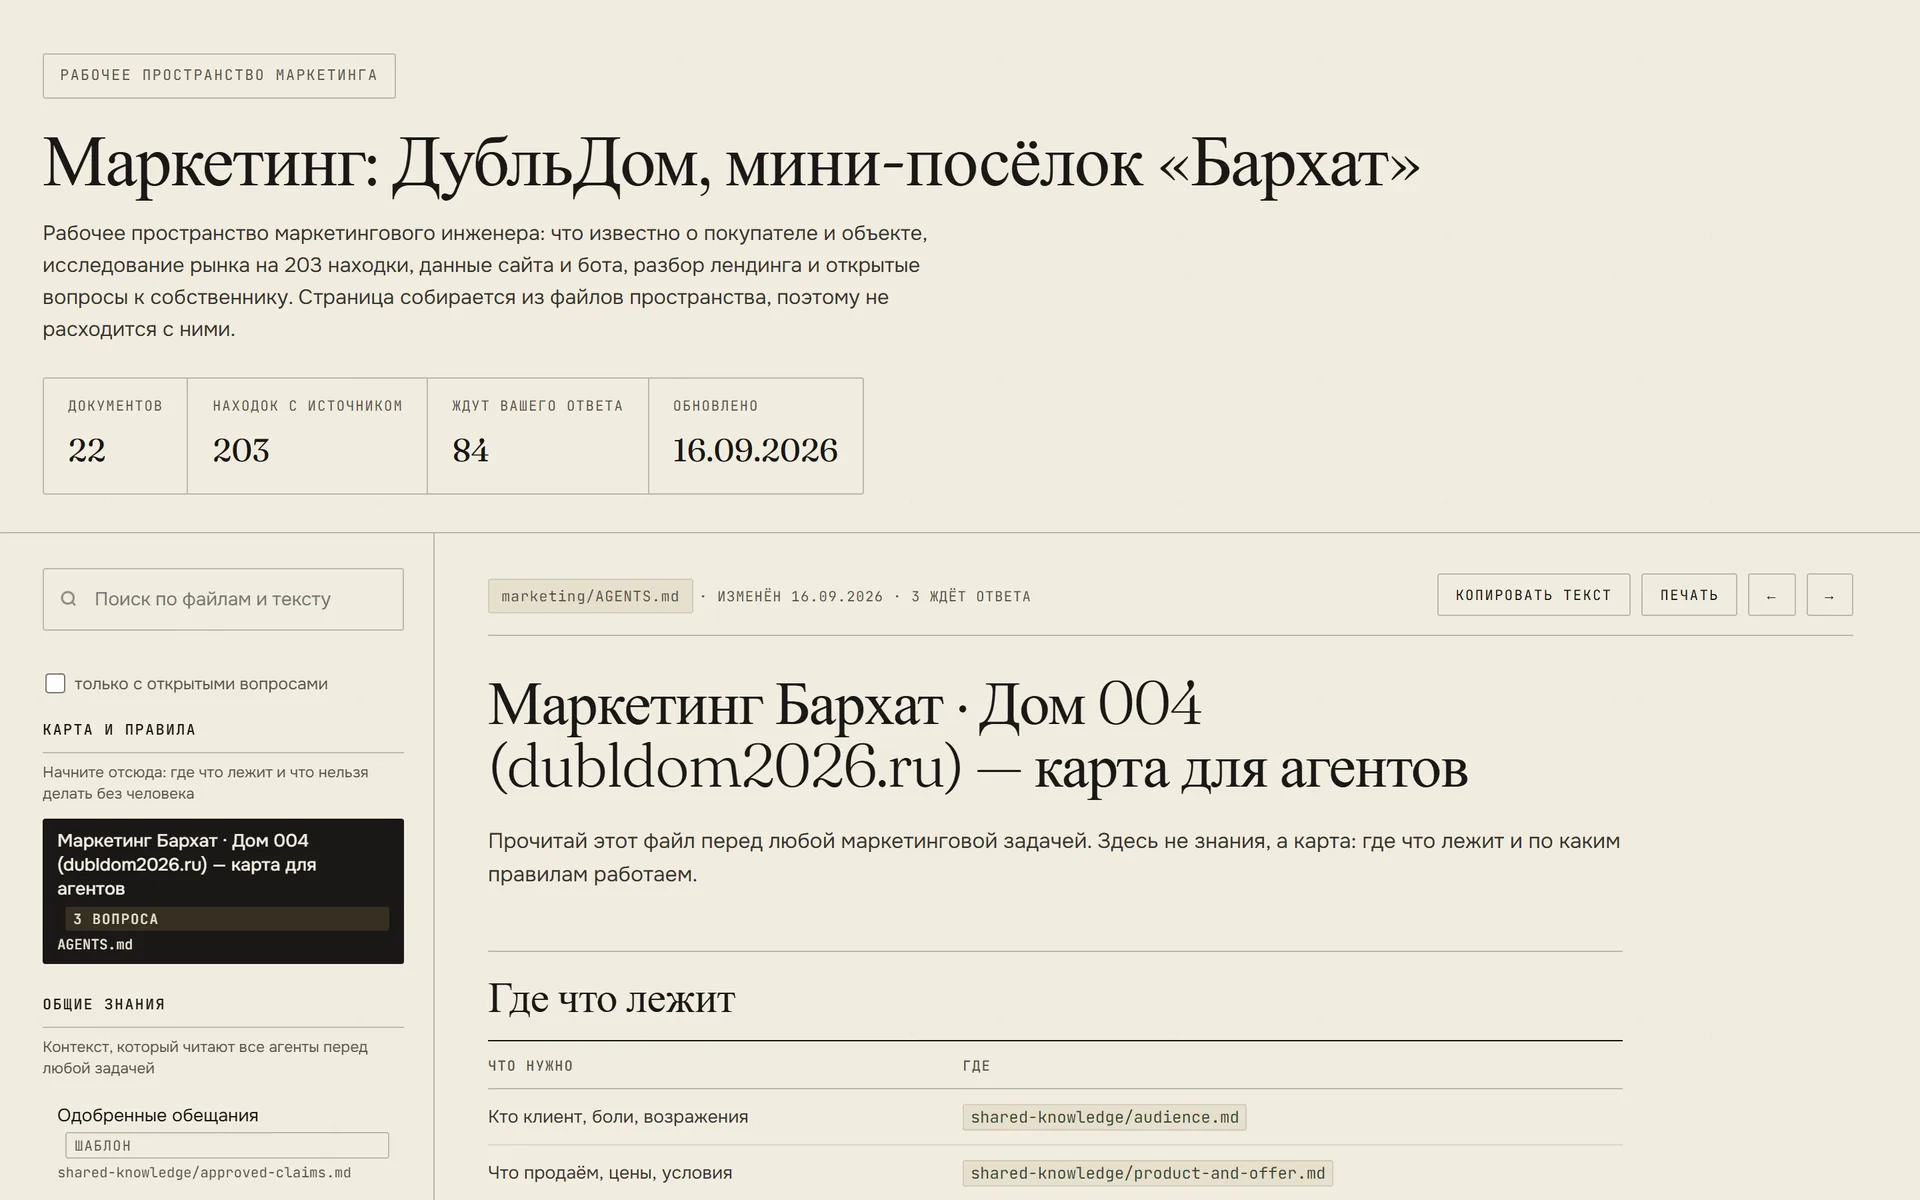
Смотреть удобнее, чем читать описание.
Что на странице:
- 22 документа в шести разделах — от карты для агентов до исследования и разбора лендинга;
- поиск по всему тексту, а не по названиям файлов, с подсветкой найденного;
- счётчик «ждут вашего ответа» — 84 места, где в файлах стоят пропуски, и фильтр «только с открытыми вопросами»;
- бейджи достоверности у каждой находки: факт, проверить, предположение;
- ссылки между документами — путь в бэктиках открывает нужный файл;
- раздел бренда с визуальным листом и палитрой.
Две детали, ради которых это вообще стоит делать. Во-первых, страница собирается из файлов, а не пишется руками, поэтому она не может разойтись с источниками: поправил знание — пересобрал. Во-вторых, оформление у неё то же, что у клиентских документов проекта, — заказчик открывает ссылку и видит привычный документ, а не вывод чужой программы.
Страница закрыта от индексации: это рабочий документ, а не публикация. Цифры на ней — на середину сентября 2026, к моменту, когда вы читаете, в проекте наверняка уже другой этап.
Что дальше
Анализ и три направления для кампании скилл сделает после ответов собственника — не раньше: без подтверждённой схемы сделки и срока готовности любые тексты придётся переписывать. Затем вертикаль paid-and-creative и кампания с тикетами: исправленные объявления на площадках → Яндекс.Директ → VK. Публикация, бюджет и новые обещания покупателям — только после «ок» собственника; это записано в AGENTS.md, и агенты читают правило перед каждой задачей.
Главный вывод примера простой. Первые находки маркетинговой системы оказались не про креатив, а про правду: что мы обещаем, что можем подтвердить и с чем нас сравнят. На это ушёл вечер, а не бюджет первого месяца.
Пример второй: клиника с двумя брендами
Первый пример — про проект, где маркетинг делают двое. Второй устроен наоборот: у клиники пластической хирургии «Мерлин» два бренда с аудиториями, которые нельзя смешивать, и накопленные материалы, в которых сначала пришлось навести порядок.
Паспорт проекта
- Что: клиника пластической хирургии, два бренда — пациентский «Мерлин» и B2B-направление Surgrent.
- Интервью: 4 вопроса.
- Пространство: одна вертикаль, 2 кампании, 10 тикетов.
- Витрина: 44 документа, 66 мест ждут ответа (в публичной копии — 42 и 63).
- Первая находка: бренд-стандарт, собранный по скриншотам, совпал с кодом сайта в двух цветах из семи.
- Ушло: одно утро. Кампании собраны и прошли модерацию, включает их человек.
«Мерлин» — пациентский бренд. Человек выбирает дорогую операцию и хочет понять, можно ли доверять клинике и конкретному хирургу. Surgrent — B2B-направление той же клиники: аренда операционной для хирургов без своей клиники. Здесь решение рациональное, и доверяют не словам, а моделям оборудования и лицензиям.
Кампании в Яндекс.Директе для обоих брендов уже были собраны и прошли модерацию, но стояли выключенными. Соблазн понятный: включить и посмотреть, что будет. Вместо этого я запустил скилл, а следом — второй, для витрины. Результат можно открыть: merlinmed.dev.uspeshnyy.ru/marketing/.
flowchart TD
    A["Репозиторий и заметки проекта"] --> B["Интервью<br/>4 вопроса"]
    B --> C["Решения<br/>вертикаль, метрика, автономия"]
    D["Бренд-стандарт<br/>собран по скриншотам"] --> E["Сверка с кодом сайта"]
    E --> F["Стандарт v2<br/>источник, дата, метка"]
    C --> G["Пространство marketing/<br/>2 кампании, 10 тикетов"]
    F --> G
    G --> H["Витрина<br/>44 документа, 66 вопросов"]
Два бренда — одна база знаний
Главный принцип скилла — у агентов один и тот же контекст. Здесь он упёрся в границу: пациенту и хирургу нельзя говорить одно и то же. Пациенту нужны спокойствие и факты о враче, хирургу — модель наркозного аппарата и условия лицензии.
Решение — одна вертикаль paid-and-creative и две кампании внутри неё. Знания об аудитории разделены на два сегмента, workflow общий, тексты — нет.
Скилл советует строить одну цепочку за раз, а я выбрал два бренда параллельно. Риск записан в decisions.md вместе с причиной: при параллели выше шанс, что обе кампании дойдут до середины и встанут. Поэтому Surgrent идёт первым — на узком B2B-рынке, около ста запросов в месяц, ошибка обходится дешевле.
Интервью: четыре вопроса
Как и в первом примере, скилл сначала прочитал всё, что было: репозиторий, прайс, карточки врачей, заметки о подключённой аналитике и конвейере заявок. В _setup/interview.md легли факты с источниками, а мне осталось четыре вопроса: с какой вертикали начинать, какой бренд первым, доходят ли данные до денег и что агент делает сам.
На последний я ответил «подскажи, как правильно». Скилл предложил стандартную границу. Черновики, отчёты и сбор данных агент делает сам. Включение рекламы, бюджеты, публикация на сайт, ответы на отзывы и новые обещания — только после подтверждения человека. Граница записана в AGENTS.md, и агенты читают его перед каждой задачей.
Самая полезная находка — в своих же файлах
В первом примере метка «проверить» отсеяла цифру из СМИ. Здесь она сработала на материалах самого проекта.
До скилла в репозитории лежал бренд-стандарт — JSON с цветами, шрифтами и готовым промптом для генерации картинок. Выглядел солидно. Но собран он был по скриншотам, и когда я проставил каждому значению источник, выяснилось:
- шрифтом системы назван Inter, а на сайте — Manrope и Hanken Grotesk;
- для второго бренда описан акцентный шрифт с засечками и даже нарисован его образец, хотя на сайте такого шрифта нет вообще;
- из семи цветов первого бренда с кодом сайта совпали два.
Каждое из этих значений уходило в промпты генерации. Каждая новая картинка тиражировала бы ошибку и выглядела бы «почти фирменной» — а это хуже явного промаха, потому что его не замечают.
Стандарт пересобран из CSS сайта: у каждого значения теперь есть источник, дата и метка. Позже скрипт второго скилла сверил его с кодом независимо от меня и нашёл одно расхождение: белый записан в коде коротко, #fff вместо #ffffff. Цвет тот же.
Генерация — для настроения, код — для точности
Визуальный лист бренда сначала сгенерировали нейросетью по промпту. Композиция вышла удачной, коды цветов подписаны верно. Потом я сверил пиксели свотчей с подписями под ними: у половины оттенок уехал, у одного — на 20 единиц из 255. Два разных золотых цвета на листе слились в один, хотя подписаны разными кодами.
Лист, вся ценность которого в точном цвете, не должен зависеть от того, попадёт ли модель в оттенок. Теперь его собирает скрипт: читает стандарт, рендерит страницу, браузер делает снимок. Отклонение — ноль. Правка цвета в стандарте пересобирает лист сама.
Нейросеть при этом осталась в работе — там, где она сильна. Обложку витрины сгенерировали по промпту в стилистике проекта: общее ядро знаний в центре, две клиники по краям, золотые траектории к ним и обратно.
Данные: только до заявки
Заявки с сайта уходят в Telegram и таблицу, но что было дальше — пришёл ли человек, состоялась ли операция — в данных не видно. Скилл не стал считать окупаемость. Метрика первой кампании — стоимость заявки, а сквозная аналитика записана отдельной задачей. Решение и причина лежат в decisions.md.
Первая задача — не объявления, а проверка
Раз кампании уже собраны, первый workflow — не «напиши объявления», а проверка перед запуском. Агент проверяет, что:
- каждое обещание в тексте есть в списке одобренных;
- в объявлениях нет точного числа врачей — клиника просила писать «более 20»;
- обещание объявления совпадает с заголовком посадочной;
- цены совпадают с прайсом и указаны как «от»;
- форма заявки работает, а метки доходят до таблицы;
- нигде нет медицинских гарантий результата.
У второго бренда блокер нашёлся ещё до проверки: цен аренды нет в машиночитаемом виде, значит объявления с ценой запускать нельзя. Тикет «Включение кампании» на доске отмечен как задача человека — агент его не выполняет.
marketing/
├── AGENTS.md                       карта и граница автономии
├── shared-knowledge/               два сегмента, прайс, обещания, голос
├── paid-and-creative/
│   └── workflows/pre-launch-check.md
├── campaigns/
│   ├── surgrent-direct-start/      бриф, доска, 5 тикетов
│   └── merlin-direct-start/        бриф, доска, 5 тикетов
└── data/data-sources.md            счётчики, доступы, дыры в данных
Витрина
Второй скилл собрал из пространства страницу: 44 документа, 76 ссылок между ними, поиск по тексту и 66 мест, где нужен ответ человека. Отдельным разделом — стандарты обоих брендов.
Шаблон витрины по умолчанию бирюзовый. Для этого проекта это не вопрос вкуса: бренд-стандарт прямо запрещает холодный синий, а витрина этот стандарт показывает. Оформление перевели на фирменные палитру и шрифты, добавили логотип, мраморную фактуру и узор лотоса из материалов клиники.
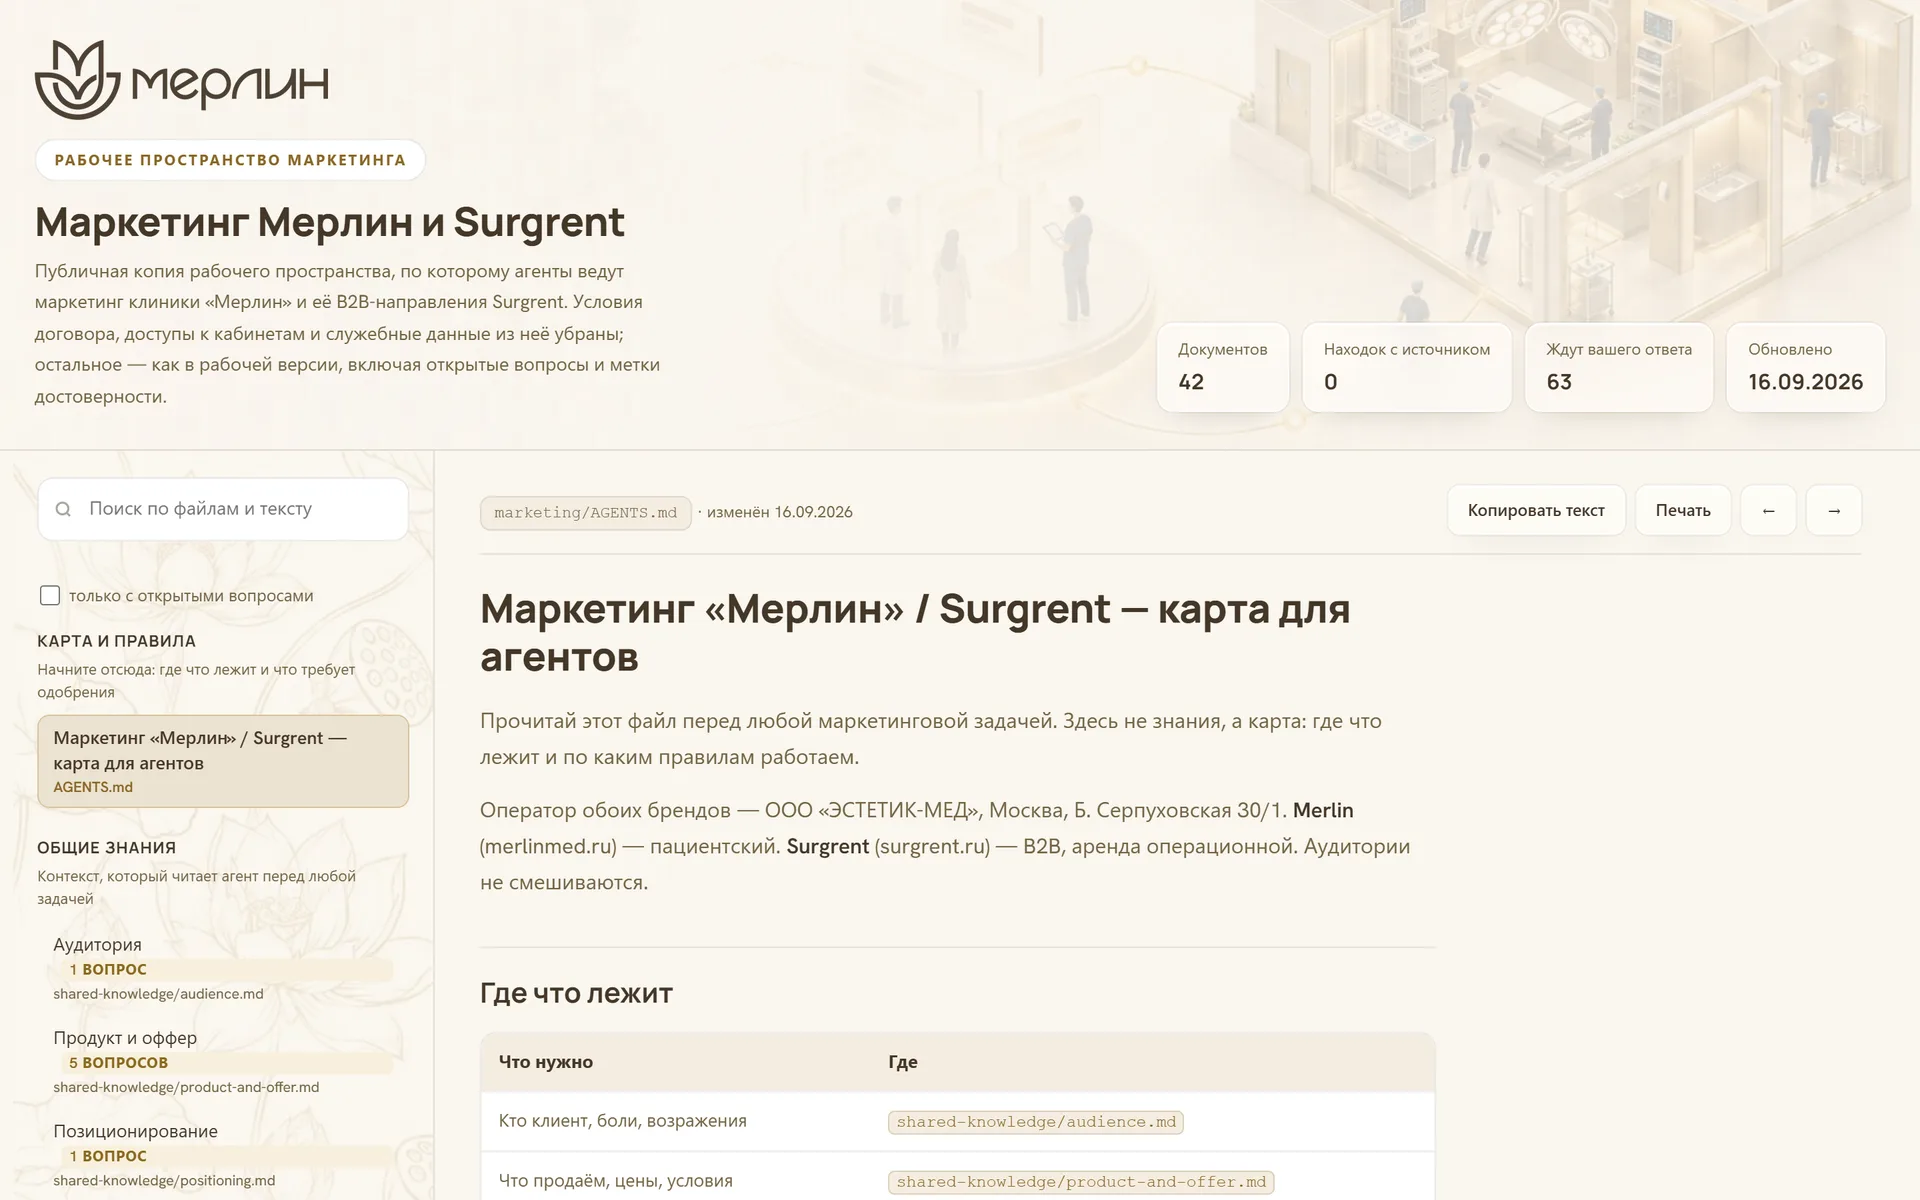
Счётчик «Находок с источником» на витрине показывает ноль, и это правда: исследование рынка ещё не запускалось, а скилл не выдаёт метки в файлах знаний за находки.
Публичная копия: вычищает скрипт, а не глаз
Рабочая витрина закрыта паролем: внутри условия договора и доступы к рекламным кабинетам. Для этого поста собрана публичная копия — 42 документа и 63 открытых вопроса.
Собирает её отдельный скрипт. Два файла он исключает целиком, ещё в четырнадцати точечно вычищает суммы, идентификаторы кабинетов и служебные пути. Потом прогоняет готовую страницу через проверку на утечки. Хоть одно совпадение — и публикация останавливается. Чтобы убедиться, что проверка вообще что-то ловит, я прогнал её по закрытой версии: сработали девять правил из одиннадцати.
Проверка окупилась сразу. Клиника просила не называть точное число врачей, и это правило записано в трёх файлах знаний. Во всех трёх — рядом с самим числом: в списке стоп-слов, в запретах, в позиционировании. Агенту так удобнее: он видит, что именно искать. А для публичной страницы это утечка, которую глазами пропустить проще всего — файл ведь как раз про то, чего не говорить.
Что дальше
Следующий шаг — исследование и анализ: конкуренты обоих брендов, отзывы пациентов (их уже собирает еженедельный бот) и спрос. Потом проверка кампаний, решение клиники по бюджету и первые заявки. Рекламу включает человек.
Главный вывод этого примера похож на первый, но с поворотом. Первое, что нашла система, — не идеи для креатива, а расхождения между тем, что записано в материалах, и тем, что есть на самом деле. Метка «проверить» оказалась нужна не только чужим цифрам, но и своим файлам. На всё ушло одно утро.
Три проекта рядом
Масштаб у проектов разный — от одного дома до двух брендов клиники. Удобнее всего сравнить их таблицей.
| ТЕЛЕМОРЕ | «Бархат» | «Мерлин» | |
|---|---|---|---|
| Что продаём | медиа-туры для подростков | один загородный дом | операции и аренду операционной |
| Брендов | один | один | два |
| Стартовое направление | работа по базе на 2426 контактов | реклама: Директ и VK | реклама в Директе |
| Находок исследования | 172 | 203 | исследование впереди |
| Документов на витрине | 42 | 22 | 44 |
| Ждут ответа человека | 22 | 84 | 66 |
| Первая находка в своих файлах | шрифты стандарта угаданы по скриншотам неверно | заготовки рекламы под другой дом | стандарт совпал с сайтом в двух цветах из семи |
Таблица листается вбок →
Самое интересное — последняя строка. Во всех трёх проектах первое, что нашла система, было не идеей для креатива, а ошибкой в собственных материалах: в стандарте бренда, в старых заготовках, в том, что считалось проверенным. Метка «проверить» нужна не только чужим цифрам.
Вывод
Маркетинговый инженер не заменяет маркетолога агентами. Он строит систему, в которой ваша экспертиза, данные и процессы связаны, а результаты каждой кампании делают следующую точнее. Строить её стоит не с архитектуры, а с одной задачи из текущей работы: со сроком, требованиями и человеком, который будет пользоваться результатом.
С чего начать завтра:
- Одна вертикаль и одна задача — со сроком и человеком, который будет пользоваться результатом.
- Общие знания, по странице на каждое: аудитория, оффер, одобренные обещания. Меньше, но точно.
- Граница автономии в
AGENTS.md: что агент делает сам, а что только после вашего «ок». - Метка «проверить» и для своих файлов. Судя по трём проектам выше, первые ошибки найдутся именно там.
Следующий шаг: выберите задачу, которую вы делаете каждую неделю и умеете оценить. Надиктуйте за десять минут всё, что о ней знаете, и прогоните через скилл или хотя бы через промпт-допрос. Отмечайте каждое место, где пришлось вмешаться, — это и есть план улучшений.
Читайте также
 Отдел маркетинга на Claude Code: 33 навыка, один файл‑начальник33 маркетинговых навыка и один файл-начальник, который распределяет задачи
 Marketing Skills: 50+ готовых навыков для AI-агента в терминалеготовые навыки для SEO, CRO, текстов и аналитики, которые можно подключить к системе
 Голос бренда в AI-контенте: как добиться, чтобы нейросеть писала и оформляла как выкак держать голос бренда, когда пишут агенты: документ, правила и проверка
Комментарии
Войдите через Telegram, чтобы оставить комментарий:
Пока нет комментариев. Будьте первым.